📝 第三章 分布式数据基础
当单体数据库要提升可用性和吞吐量时,避免不了要对数据库进行扩展,我们的系统就从单台数据库迈向了分布式架构。当单台机器转为分布式系统后,我们该如何存储数据集,该如何进行数据同步。
一、分区
分区指的是将一个数据集拆分成多个较小的数据集,同时将存储和处理这些较小数据集的责任分配给分布式系统中的不同节点。数据分区后,我们就可以通过向系统中增加更多节点来增加系统可以存储和处理的系统规模。
分区增加了数据的可管理性、可用性和可扩展性。
1.1 垂直分区
垂直分区是对表的列进行拆分,将某些列的整列数据拆分到特定的分区,并放入不同的表中。垂直分区减小了表的宽度,每个分区都包含了其中的列对应的所有行。垂直分区也被称为“行拆分(RowSplimng)”,因为表的每一行都按照其列进行拆分。例如,可以将不经常使用的列或者一个包含了大text类型或BLOB类型的列垂直分区,确保数据完整性的同时提高了访问性能。值得一提的是,列式数据库可以看作已经垂直分区的数据库。
1.2 水平分区
水平分区是对表的行进行拆分,将不同的行放入不同的表中,所有在表中定义的列在每个分区中都能找到,所以表的特性依然得以保留。举个简单的例子:一个包含十年订单记录的表可以水平拆分为十个不同的分区,每个分区包含其中—年的记录(具体的分区方法我们会在后面详细讨论)
1.3 垂直分区和水平分区的对比
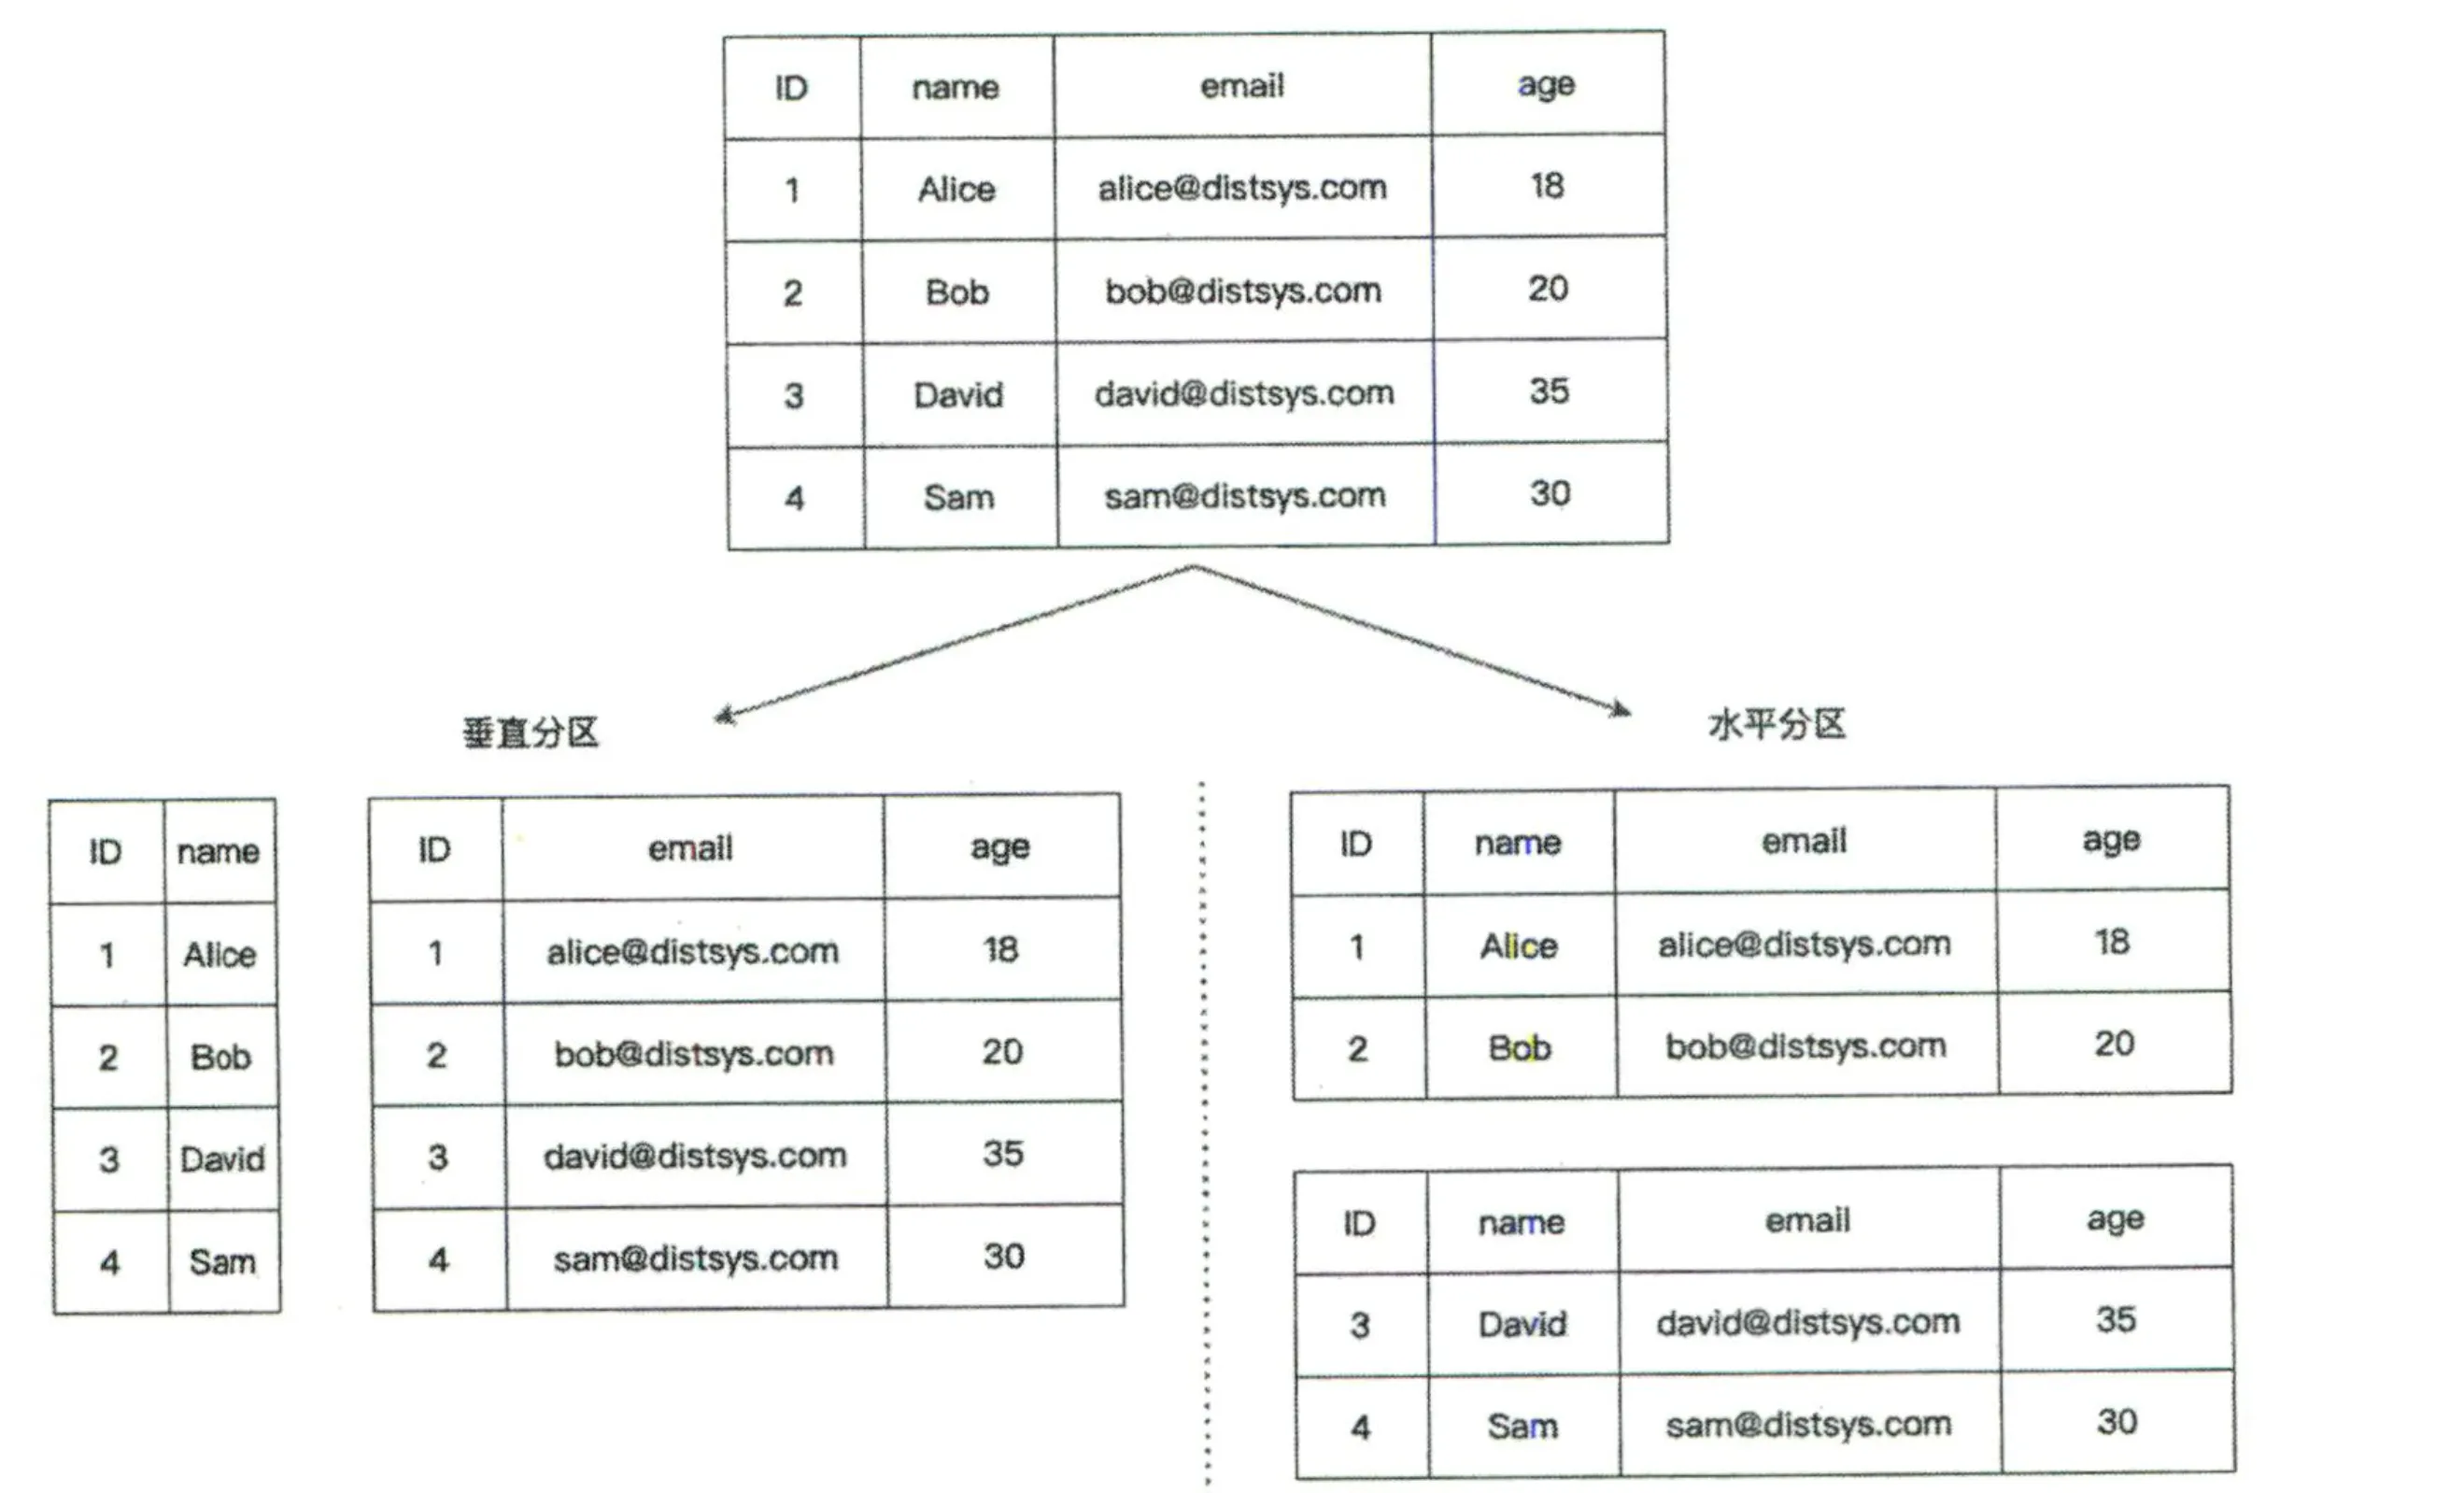
垂直分区的问题在于它与列相关,而一个表中的列是有限的,这就导致了垂直分区不能超过一定的限度,而水平分区则可以无限拆分。另外,表中数据以行为单位不断增长,而列的变动很少,因此,水平分区更常见。
在分布式系统领域,水平分区常称为分片(Shardlng)。需要说明的是,很多图书和文章会纠结分片和分区的具体区别,一种观点认为,分片意味着数据分布在多个节点上,而分区只是将单个存储文件拆分成多个小的文件,并没有跨物理节点存储。由于本书重点讨论的是分布式系统,因此无论是分区还是分片,本书都认为其数据分布在不同物理机器上。
分片在不同系统中有着各种各样的称呼,MongoDB和ElasticSearch中称为shard,HBase中称为region,Bigtable中称为tablet, Cassandra和Riak中称为vnode。
1.4 水平分区算法
- 范围分区
范围分区(RangePartitioning)是指根据指定的关键字将数据集拆分为若干连续的范围,每个范围存储到—个单独的节点上。用来分区的关键字也叫分区键。前面介绍的按年拆分表数据就是—个范围分区的例子,对于201l年到2020年这十年的订单记录,以年为范围,可以划分为l0个分区,然后将20ll年的订单记录存储到节点Nl上,将20l2年的订单记录存储到节点N2上,以此类推。
例如下图中根据年龄进行范围分区。
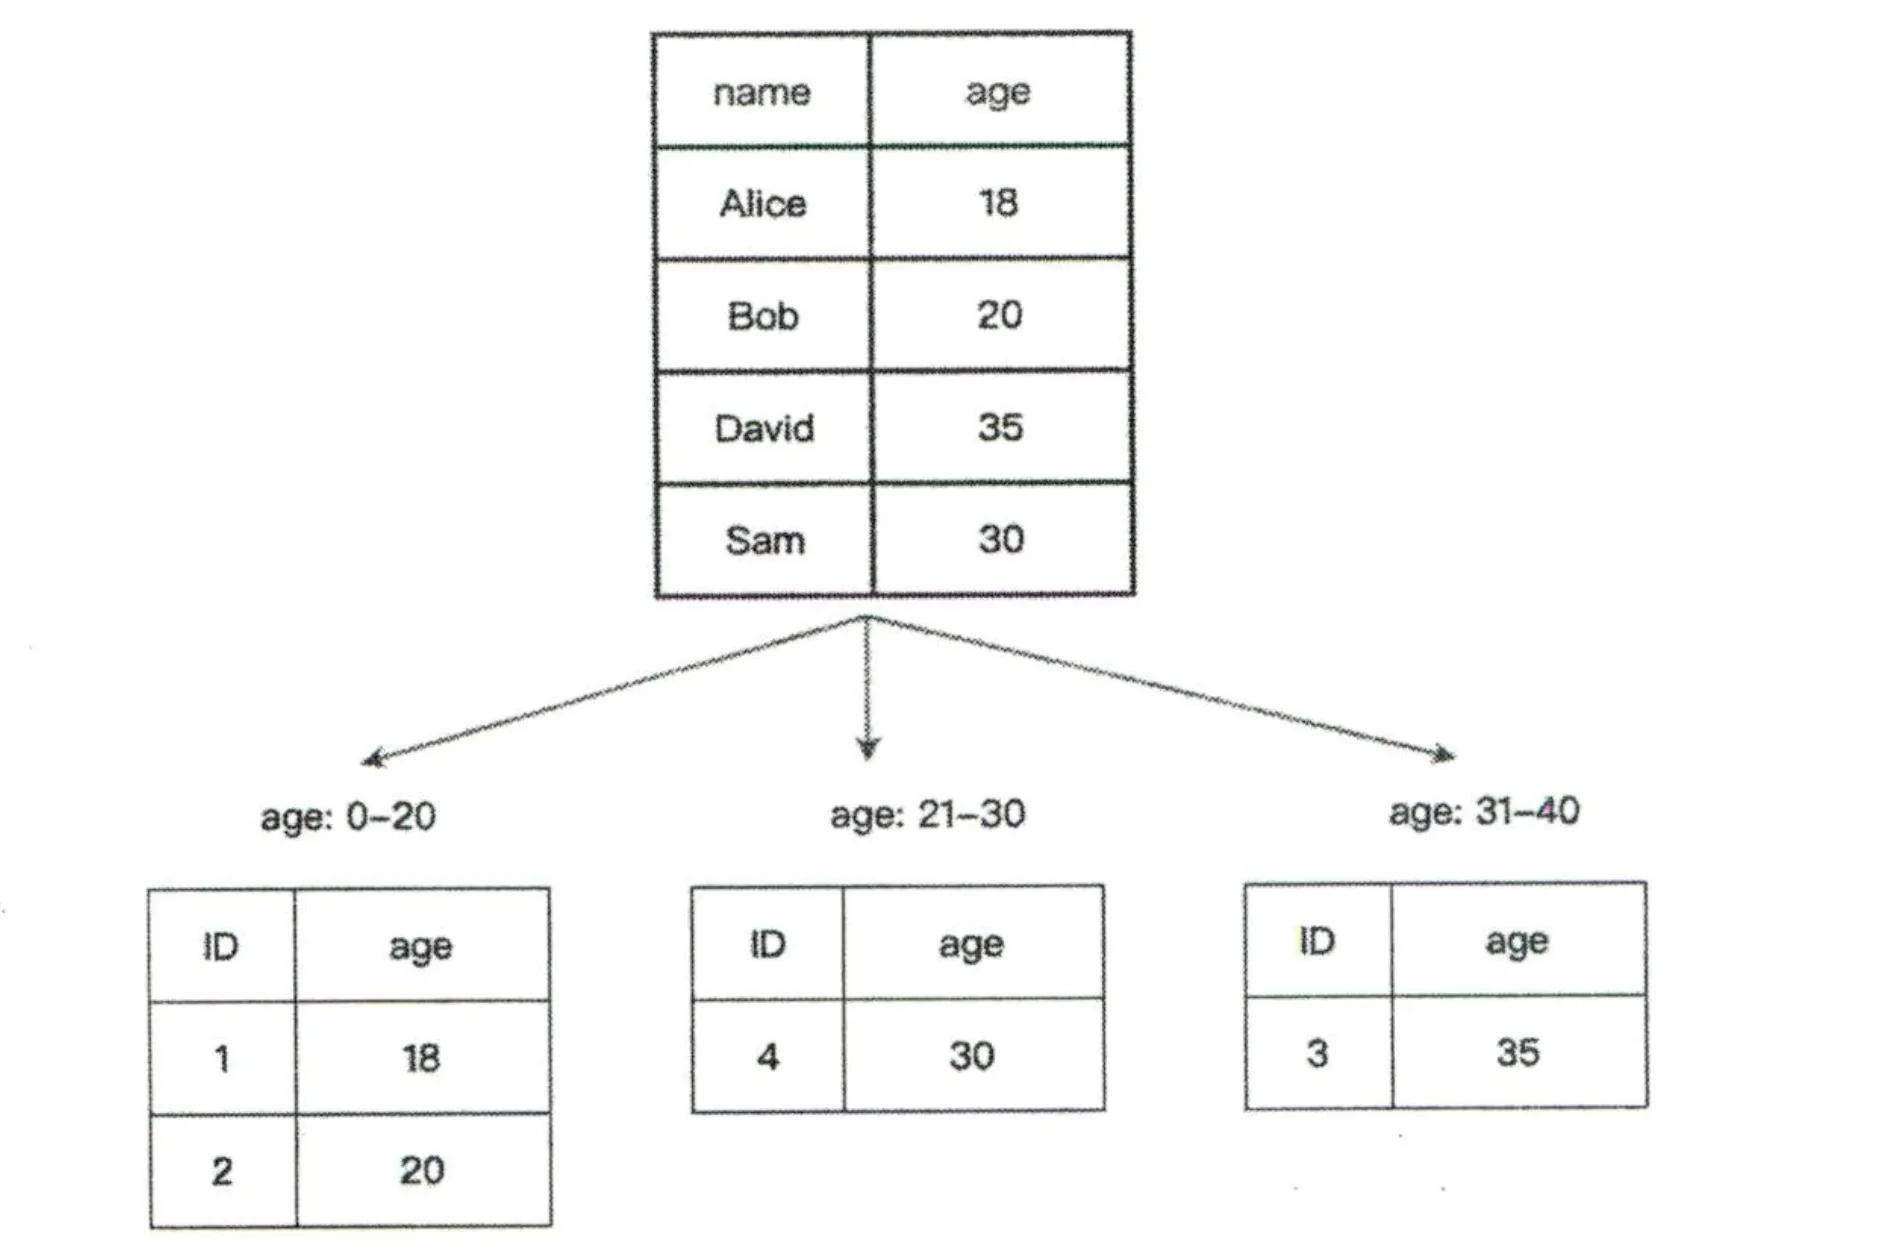
如何划分范围可以由管理员设定,或者由存储系统自行划分。通常会选择额外的负载均衡节点或者系统中的一个节点来接收客户端请求,然后根据范围分区算法,确定请求应该重定向(路由)到哪个节点或哪几个节点。(也就是必须有一个节点来接收客户端请求)
范围分区的主要优点有:
- 实现起来相对简单
- 能够对用来进行范围分区的关键字执行范围查询
- 当使用分区健进行范围查询的范围较小且位于同一个节点时,性能良好
- 很容易通过修改范围边界增加或减少范围数据,能够简单有效地调整范围(重新分区),以负载均衡
范围分区的主要缺点有:
- 无法使用分区键之外的其他关键字进行范围查询
- 当查询的范围较大且位于多个节点时,性能较差
- 可能产生数据分布不均或请求流量不均的问题,导致某些数据的热点现象,从而某些节点的负载会很高。例如,当我们将姓氏作为分区键时,某些姓氏的人非常多(比如姓李或者姓王),这会造成数据分布不均。又例如前面的按年拆分订单的例子,虽然数据分布较为均衡,但根据日常生活习惯,最近一年的订单查询流量可能比前几年的查询流量加起来还要多,这就会造成请求流量不均。总的来说,—些节点可能需要存储和处理更多的数据和请求,一般通过继续拆分范围分区来避免热点问题
使用范围分区的分布式存储系统有Google Bigtable、Apache HBase2和PingCAP TiKV。
范围分区适合那些需要实现范围查询的系统。
- 哈希分区
哈希分区(Hash Partitioning)的策略是将指定的关键字经过一个哈希函数的计算,根据计
算得到的值来决定该数据集的分区,如下图
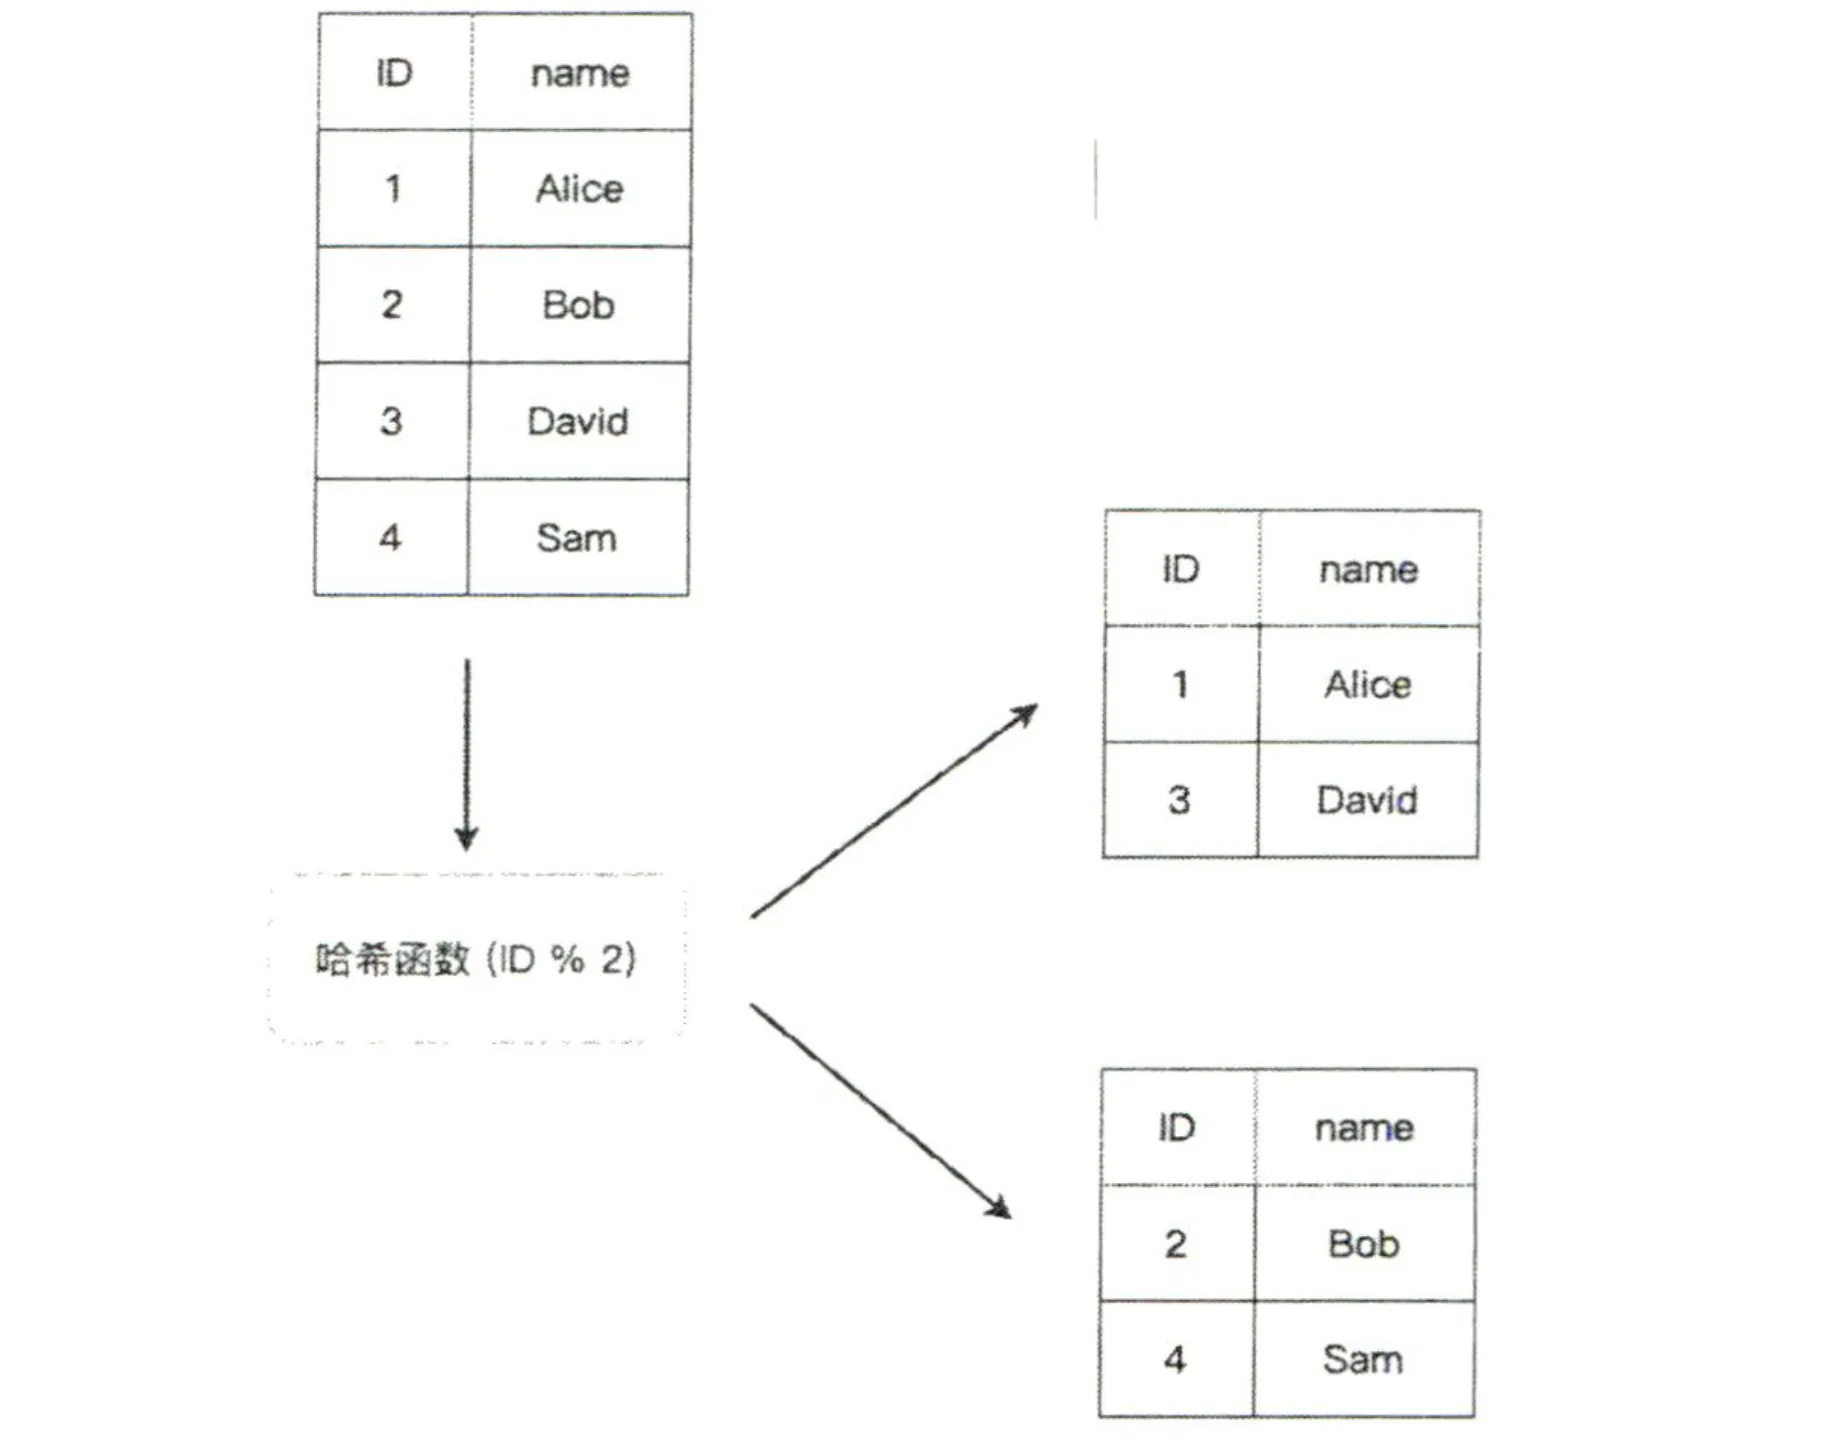
哈希分区的优点是
- 数据的分布几乎是随机的,所以分布相对均匀,能够在一定程度上避免热点问题。
但是哈希分区不能直接使用于生产,它有以下的缺点:
- 不额外存储数据的情况下,无法执行范围查询。
- 添加或删除节点时,由于每个节点都需要一个相应的哈希值,所以增加节点需要修改哈希函数,这会导致许多现有的数据都要重新映射,引起数据大规模移动。并且在此期间,系统可能无法继续工作。
使用分布式数据库的原因就是因为它方便扩展,而且必定会扩展。但是哈希分区的致命缺点就是添加和删除节点非常复杂,所以产生了一致性哈希的分区方式。
- 哈希分区
一致性哈希(Consistent Hashing)是一种特殊的哈希分区算法,在分布式存储系统中用来缓解哈希分区增加或删除节点时引起的大规模数据移动问题。
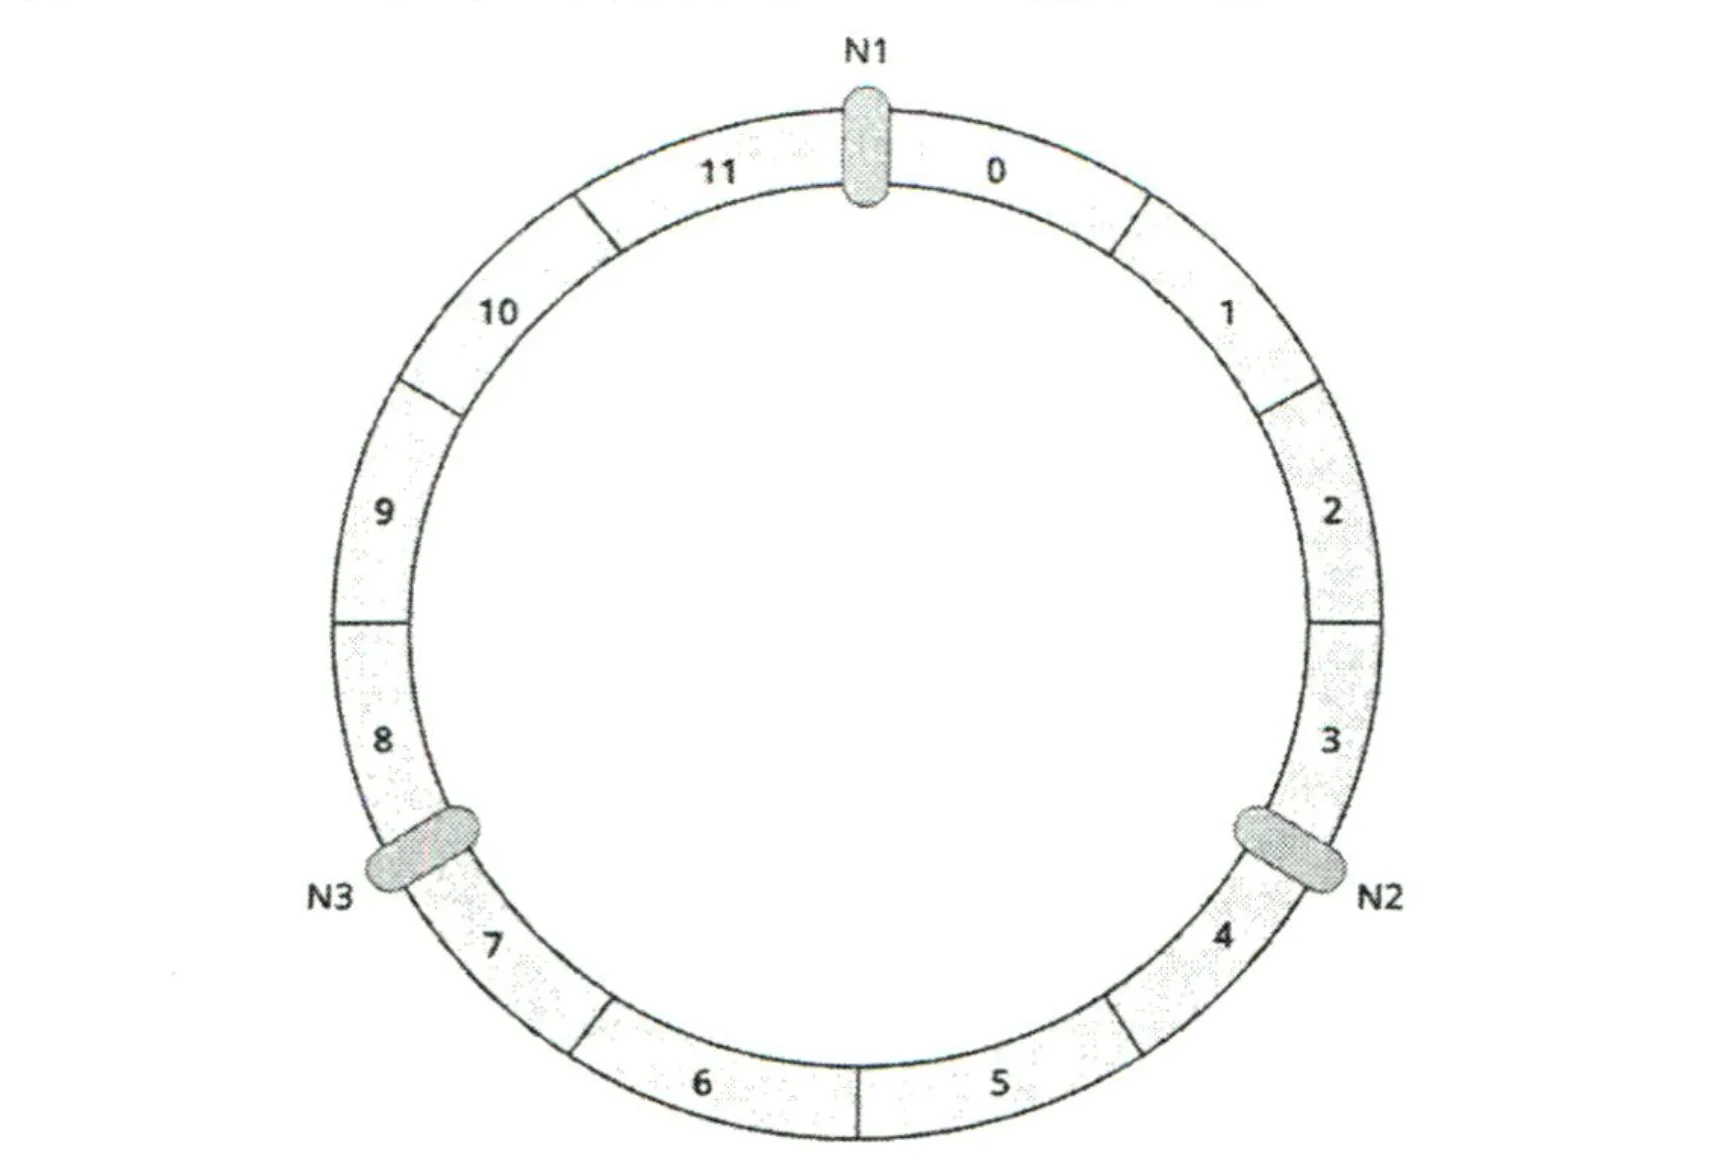
一致性哈希算法将整个哈希值组织成一个抽象的圆环,称为哈希环(Hashing Ring)。哈希函数的输出值一般在0到INT_MAX(通常为 ~ 1)之间,这些输出值可以均匀地映射到哈希环边上。举个例子,假设哈希函数hash()的输出值大于/等于0 小于/等于11,那么整个哈希环看起来如下图所示。
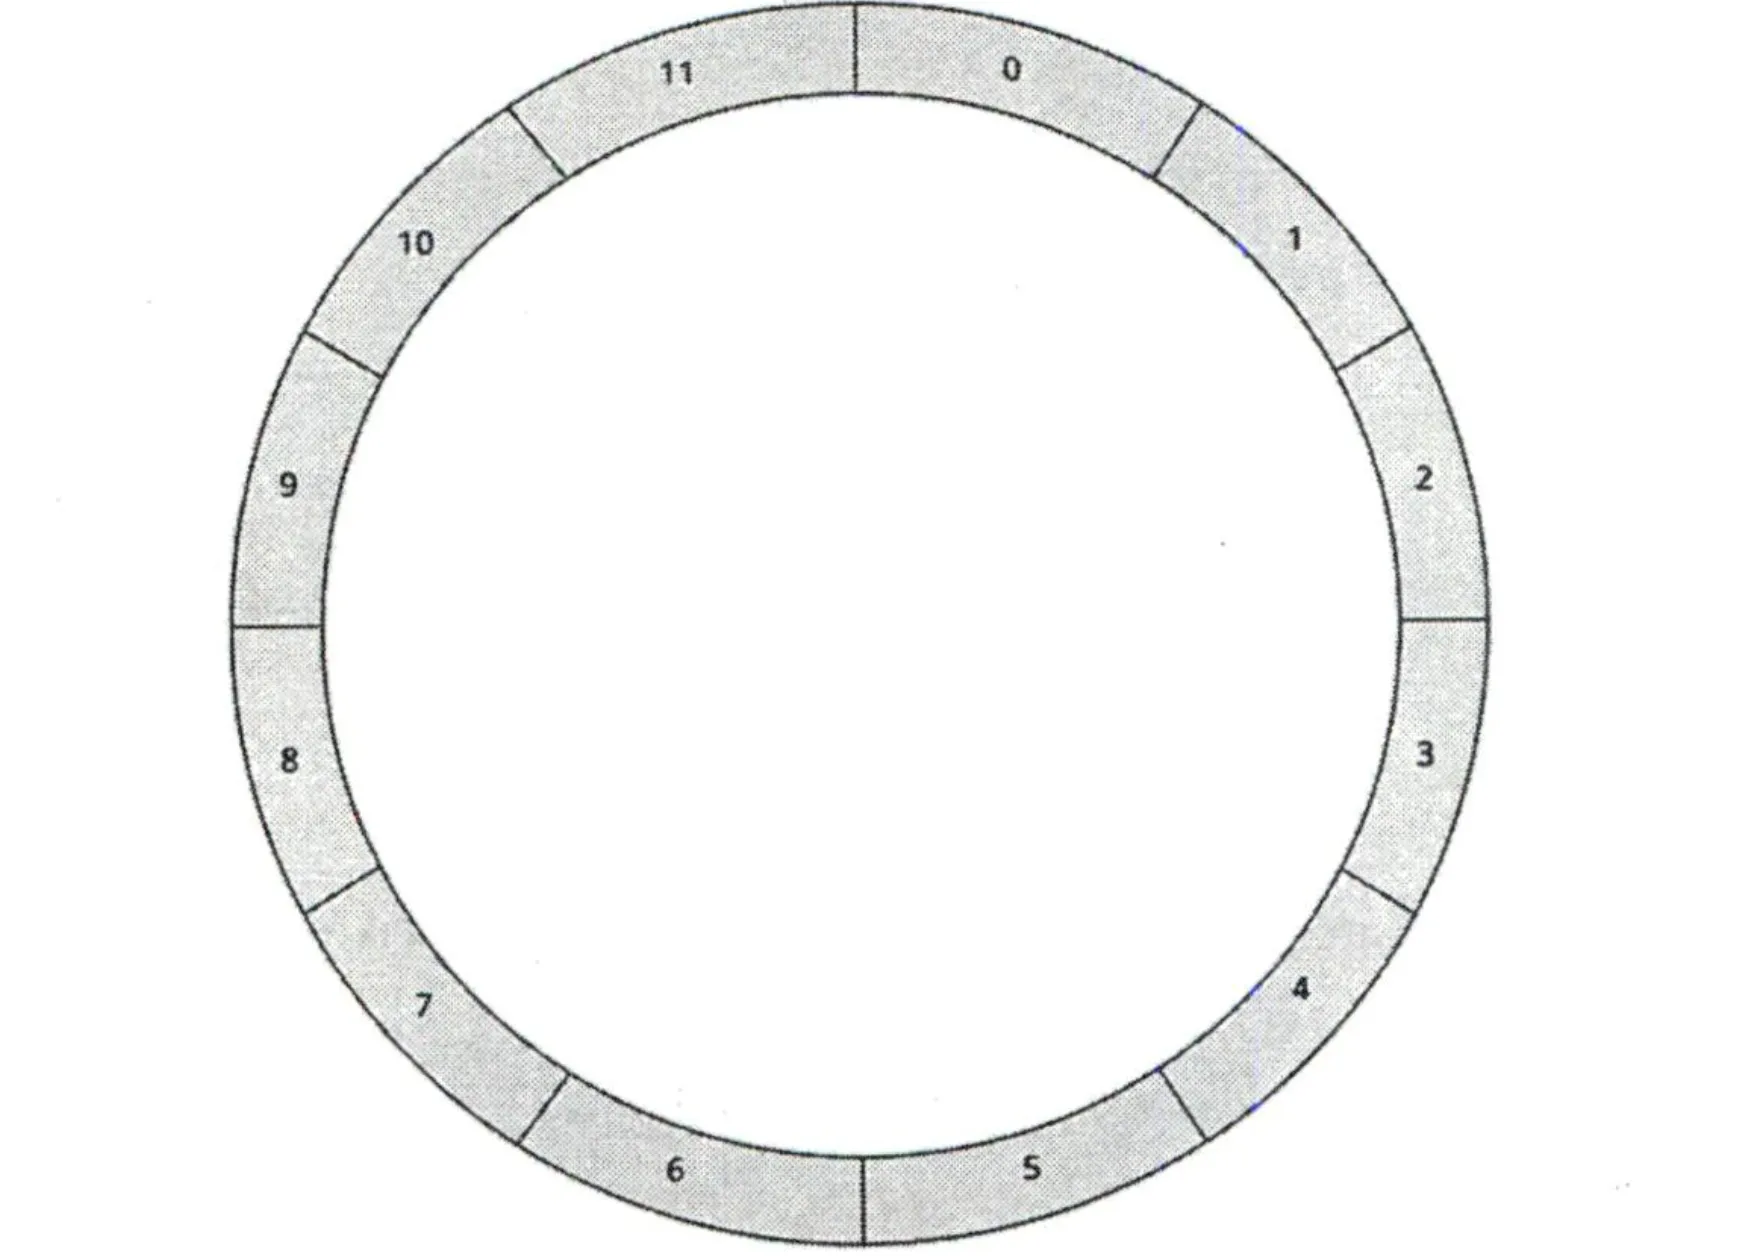
接下来将分布式系统的节点映射到圆环上。假设系统重有三个节点,系统管理员可以直接将机器名称或IP地址将节点映射到环上。如下图所示。
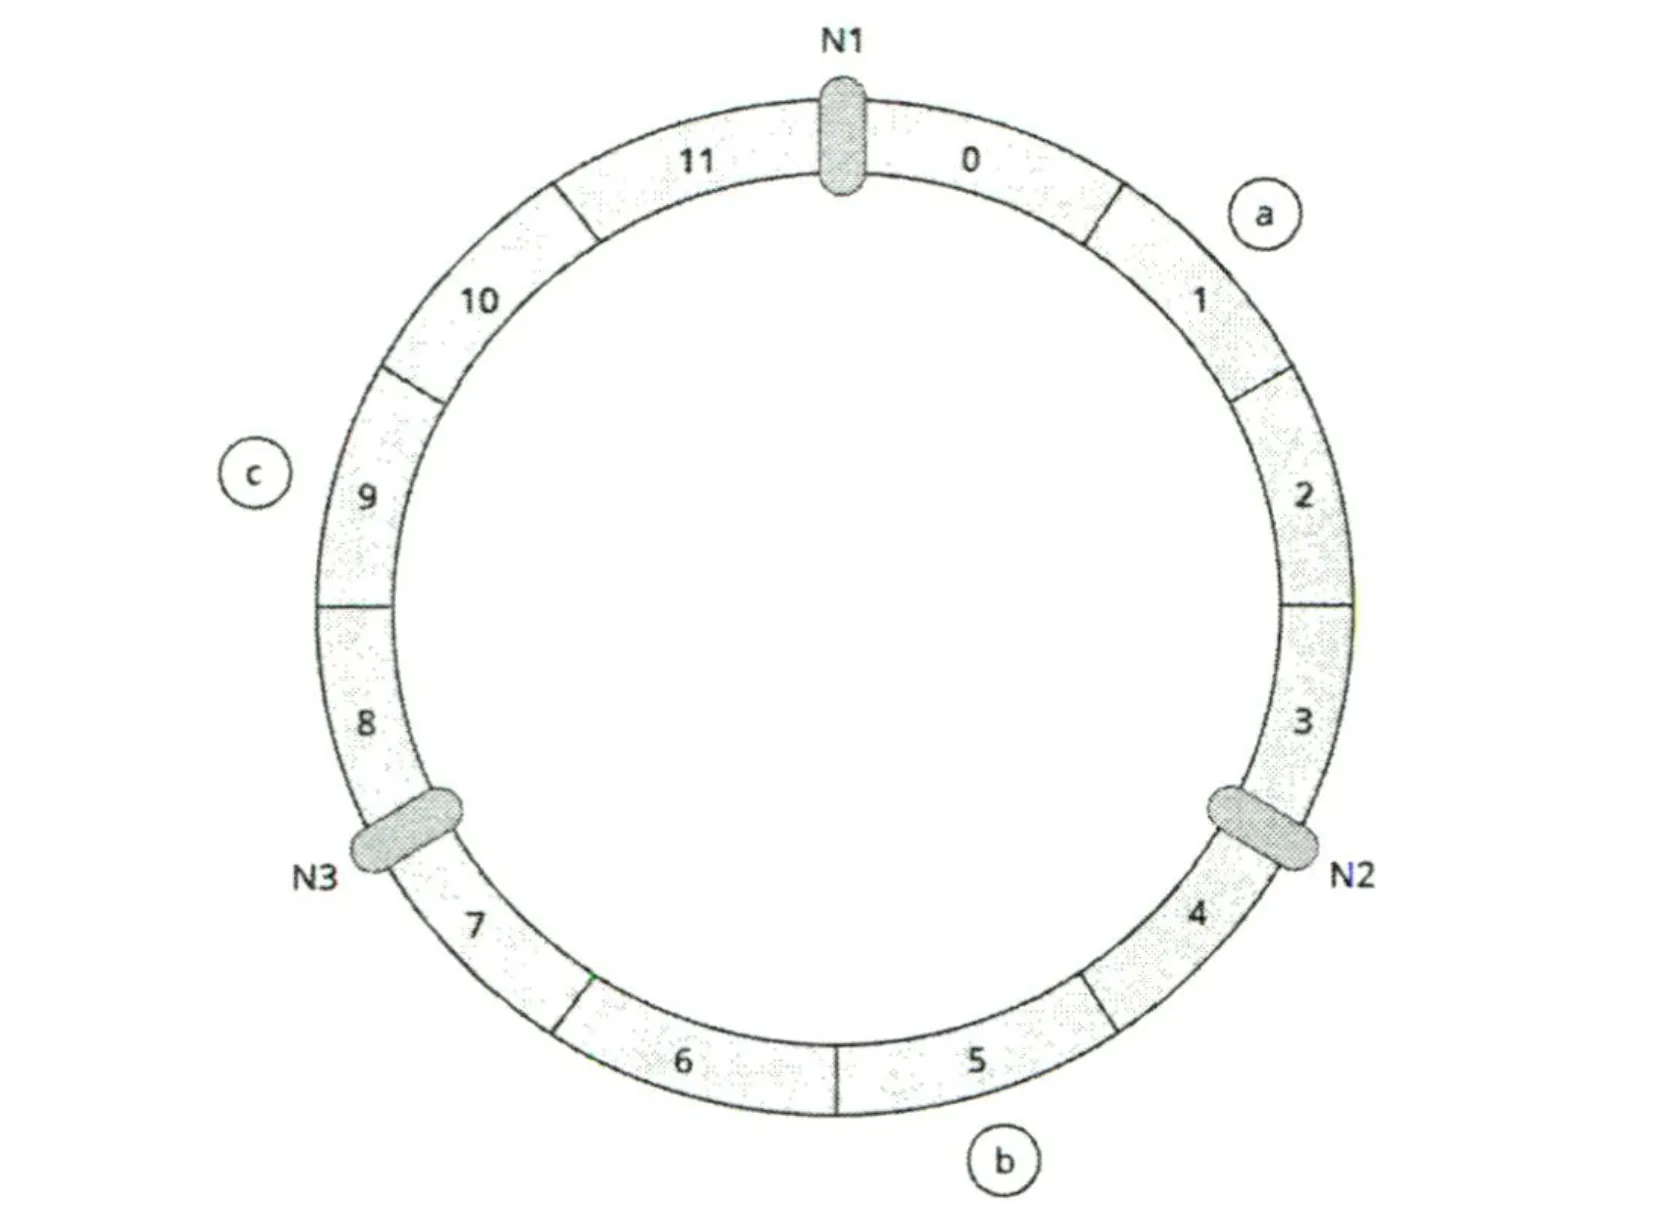
接着,将需要存储的数据的关键字输入哈希函数,计算出哈希值,根据哈希值将数据映射到哈希环上。假设此时要存储三个键值对数据,它们的关键字分别为a、b和c,假设经过哈希函数计算后的哈希值分别为l、5和9,则数据映射到环上后,如图所示。
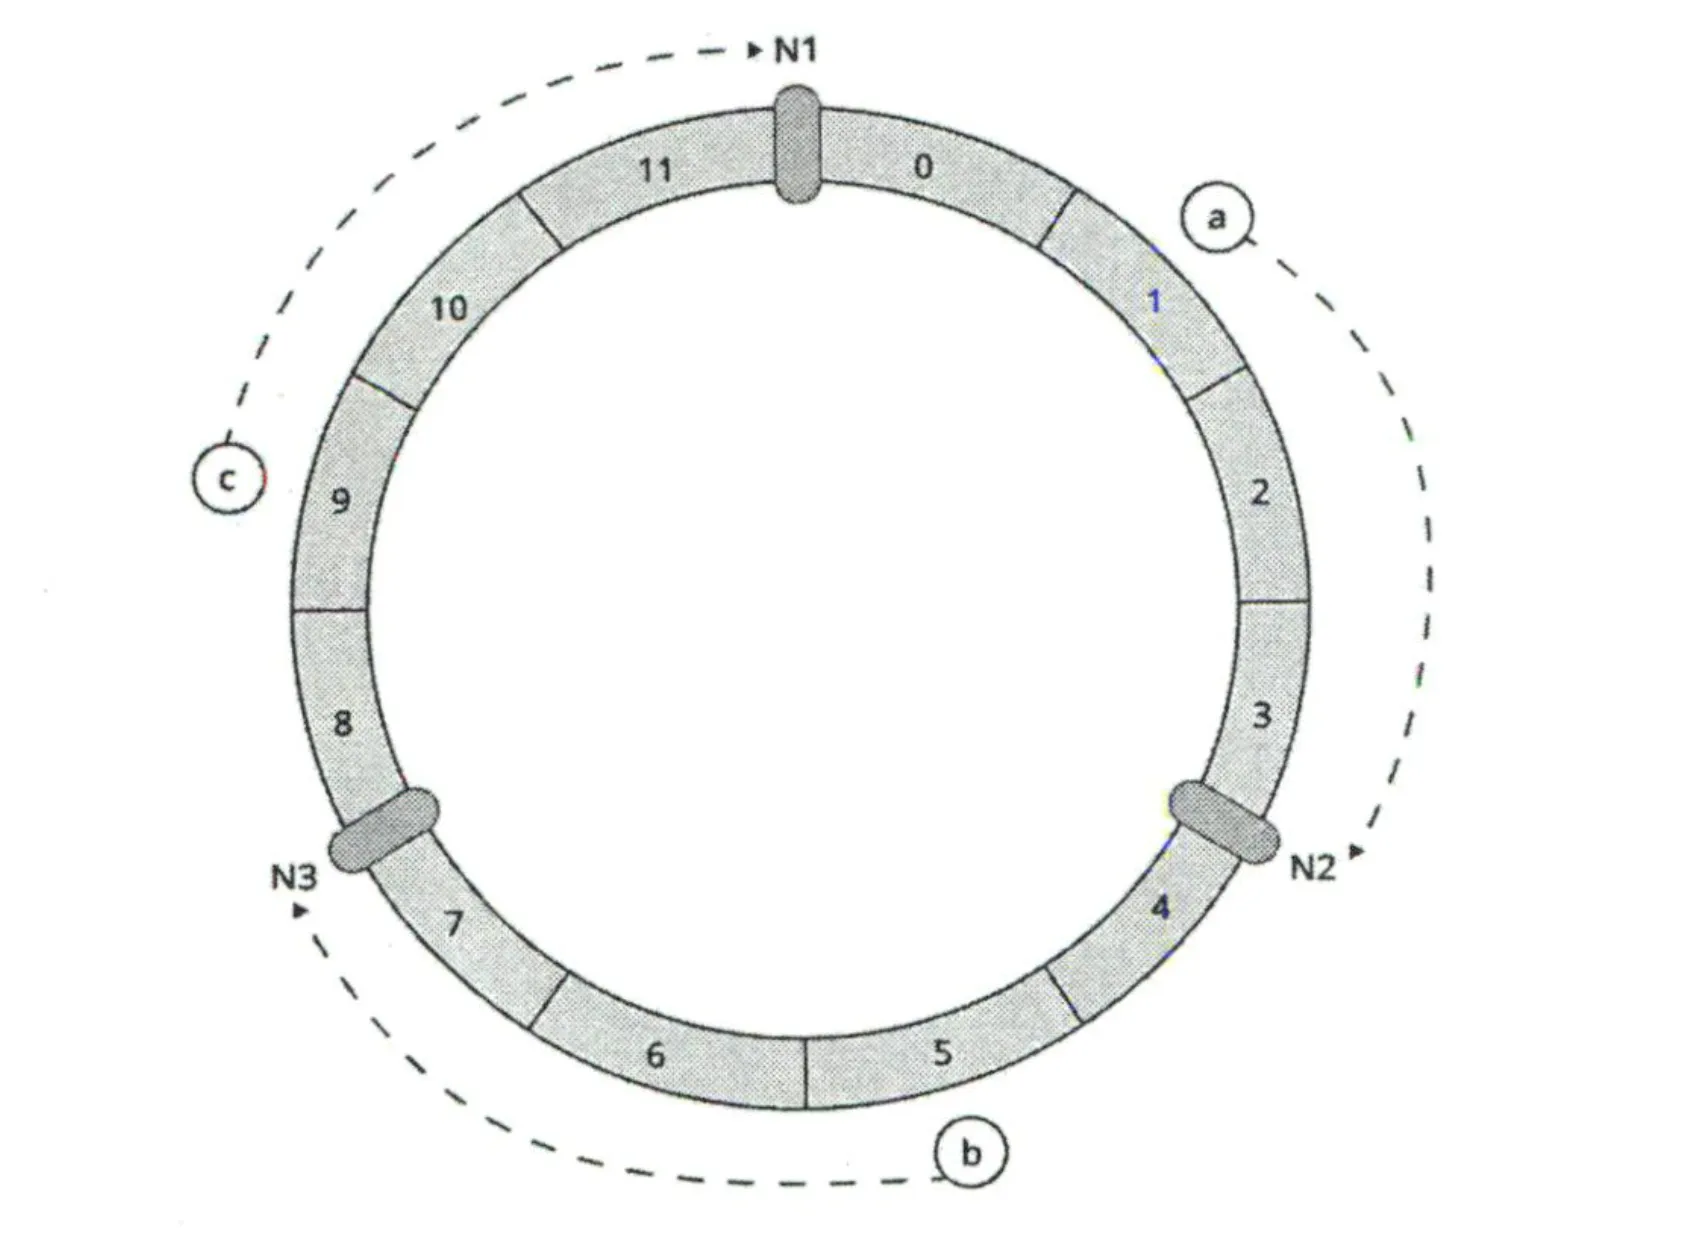
那么数据具体分区到哪个节点上呢?在一致性哈希算法中,数据存储在按照顺时针方向遇到的第一个节点上。例如上图中,关键字a顺时针方向遇到的第一个节点是N2,所以a存储在节点N2上;同理,关键字b存储在节点N3上,关键字c存储在节点Nl上。数据分布方法如下图所示
接下来我们继续看一下,向集群中添加一个节点会发生什么。假设集群此时要添加一个节点N4,并添加到如下图所示的哈希环位置。那么,按照顺时针计算的方法,原本存储到节点N2上的关键字a将转移到N4上,其他数据保持不动。
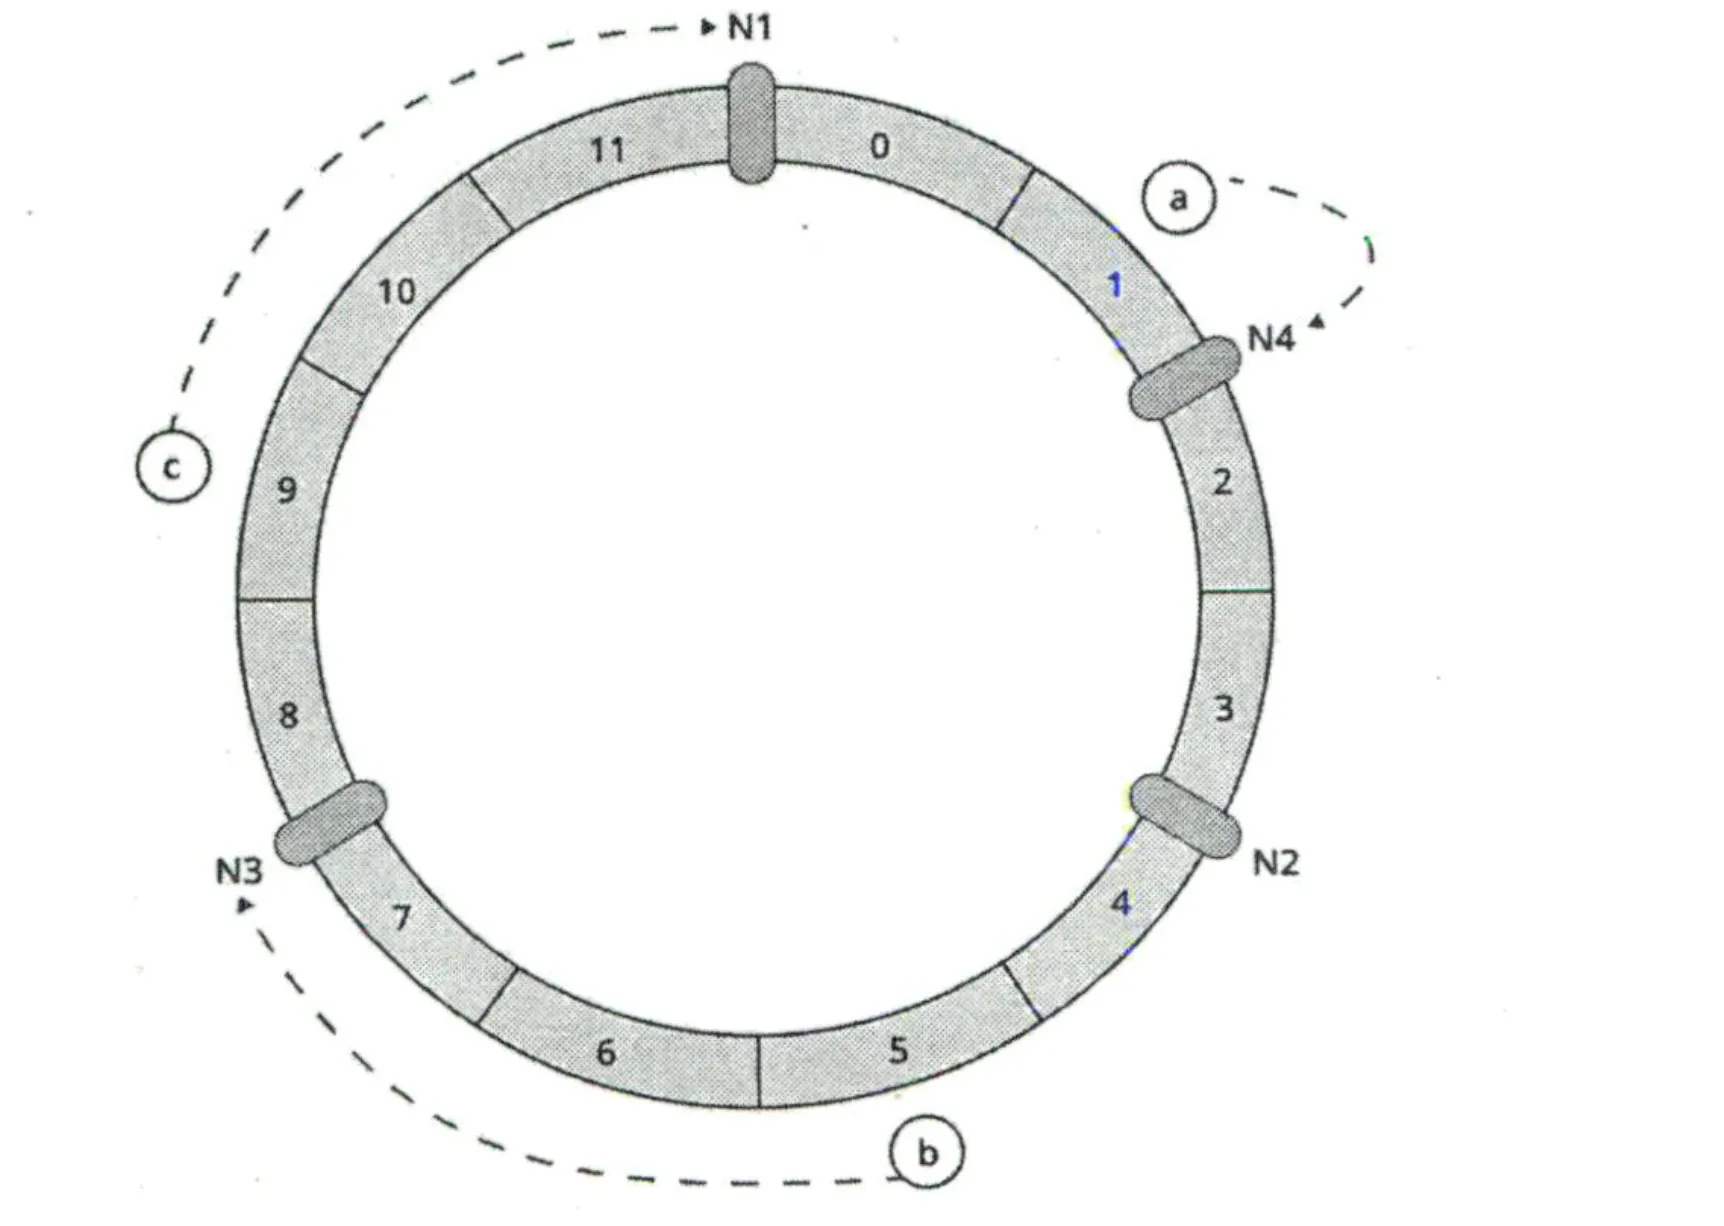
可见,相比于普通的哈希分区添加或删除节点时会导致大量映射失效,—致性哈希很好地处理了这种情况。对于添加—台服务器这种情况,受影响的仅仅是新节点在哈希环上与相邻的另一个节点之间的数据,其他数据并不会受到影响。
一致性哈希对于节点的增减只需要重新分配哈希环上的一部分数据,改善了哈希分区大规模迁移的缺点。此外,—致性哈希也不需要修改哈希函数,直接将新节点指定到哈希环上的某个位置即可。相比简单的哈希分区,一致性哈希有着更好的可扩展性和可管理性。
但是,一致性哈希仍然有明显的缺点,当系统节点太少时,还是容易产生数据分布不均的问题。另外,一个较为严重的缺点是,当一个节点发生异常需要下线时,该节点的数据全部转移到顺时针方向的节点上,从而导致顺时针方向节点存储大量数据,大量负载会倾斜到该节点。
解决这个问题的方法是引入虚拟节点(Virtual Node),虚拟节点并不是真实的物理服务器,虚拟节点是实际节点在哈希环中的副本,一个物理节点不再只对应哈希环上一个点,而是对应多个节点。我们假设—个物理节点要映射到哈希环中的三个点,引入虚拟节点后的哈希环如下图所示。可以很直观地发现,虚拟节点越多,数据分布就越均匀。当节点发生异常被迫下线时,数据会分摊给其余的节点’避免某个节点独自承担存储和处理数据的压力。
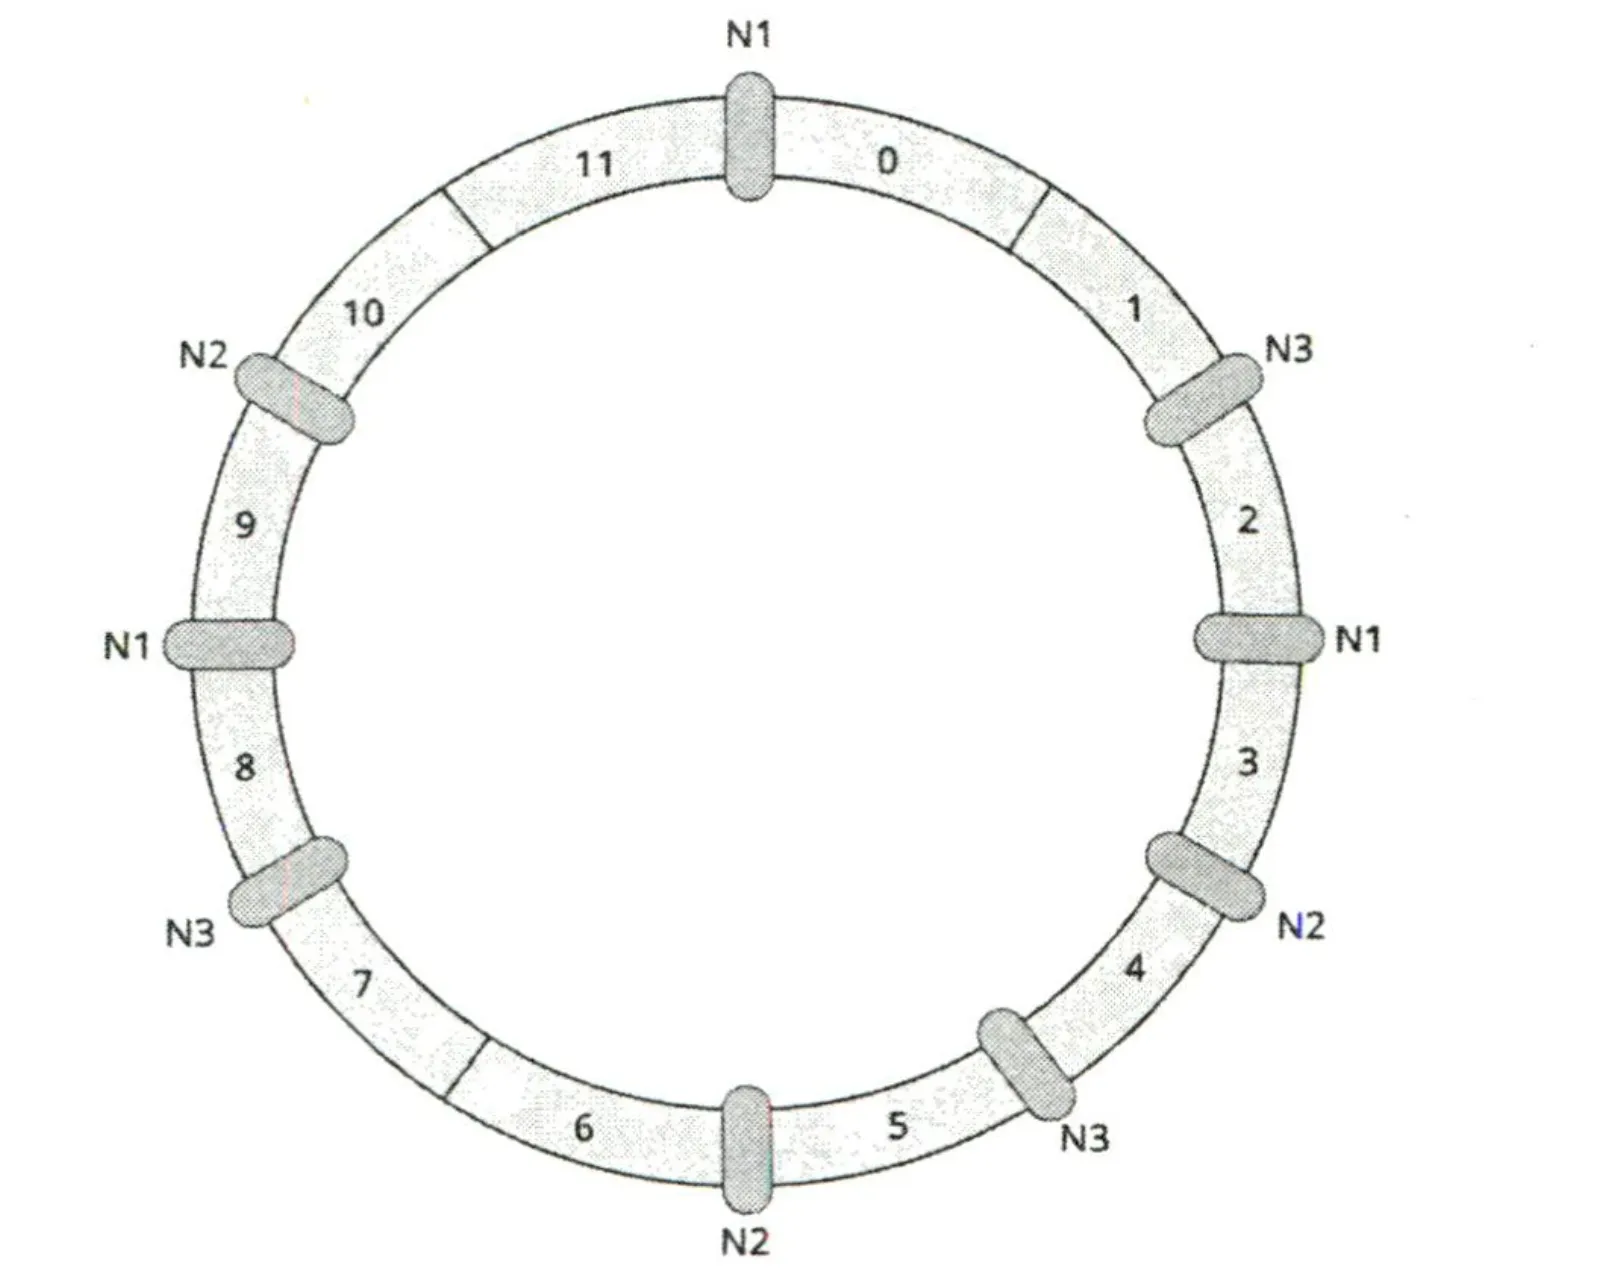
如果系统中有不同配置、不同性能的机器,那么虚拟节点也很有用。例如,系统中有一台机器的性能是其他机器的两倍,那么我们可以让这台机器映射出两倍于其他机器的节点数,让它来承担更多的负载。
不过,在不额外存储数据的情况下,一致性哈希依然无法高效地进行范围查询。任何范围查询都会发送到多个节点上。
1.5 分区带来的挑战
虽然分区有助于让系统高效地处理较大的数据集,并且易于扩展,但也带来了一些限制。
1.查询
在一个垂直分区的数据集中,将不同表的数据组合起来的查询(即join查询)会非常低效。因
为这些请求可能需要访问多个节点的数据。
这种情况在水平分区的系统中可以避免,因为每一行的所有数据都位于同一个节点中。但是,对于需要查询许多行的范围查询来说,可能这些行位于不同的节点,请求也会访问多个节点。
2.事务
数据存储在单台机器上时实现事务的难度尚可,但在分布式系统中想要实现事务就比较困难,这一点我们将在第5章“分布式事务”中详细讨论
二、复制
分区将数据和负载分配到多个节点,提高了系统的可扩展性和性能。为了提高可用性,除了分区还需要复制(Replication)。复制是指将同一份数据冗余存储在多个节点上,节点间通过网络来同步数据,使之保持一致。一个存储了复制数据的节点称为副本(Replica)。复制可以和分区一起使用。
1.优点
- 增强数据的可用性和安全性
如果只把数据存放在单一的数据库服务器上,一旦该服务器永久损坏,将导致数据丢失、服务停止。数据备份已经是运维人员的共识。通过复制技术将数据冗余存储,即使系统部分节点发生故障,系统也能继续工作,有时用户甚至没有发现系统部分节点出现过问题。
- 减少往返时间
不管你的数据库的处理有多快,数据仍然需要从客户端发起请求,通过网络传输到服务端,服务端处理完之后,数据也需要重走一遍来路,返回到客户端,这一段时间被称为往返时间(Round-TripTime,RTT),往返时间是无法避免的。
通过复制技术把数据存储到各个数据中心,可以将全国各地甚至全球不同用户的请求重定向到离用户位置更近的副本,减少往返时间,提升响应速度。
- 增加吞吐量
一台服务器能够处理的请求数存在物理上限,这种情况下复制出同样的几台服务器,可以提供更多处理读写请求的机器,系统的处理性能能够成倍增长。
2.缺点
- 增加了系统的复杂性
复制意味着系统中的每份数据会有多个副本,这些副本在每次更新时必须—起更新或相互同步数据。理想情况下,复制应该对客户端来说无感知,即营造出一种每份数据只有一个副本的假象。要
实现理想的情况总是不太容易,网络延迟总是会“捣鬼”。有时为了保障系统的性能,需要放弃
一些其他的属性,甚至允许在特定的条件下,返回一些过期的、反直觉的数据。
3.复制算法-单主复制
单主复制也叫主从复制或主从同步,即指定系统中的一个副本为主节点(有Leader、Master
或Primary等多种叫法),客户端的写请求必须发送到主节点;其余的副本称为从节点(对应
Follower、Slave或Backup),从节点只能处理读请求,并从主节点同步最新的数据。
主节点收到写请求时,除了将数据写入本地存储,还要负责将这次数据变更同步给所有从
节点, 以确保所有的副本保持数据一致。数据变更同步具体是同步操作日志还是转发请求,不
同的系统有着不同的实现。
根据系统以何种方式同步数据,又可以将单主复制分为三类,分别为同步复制、异步复制
和半同步复制。
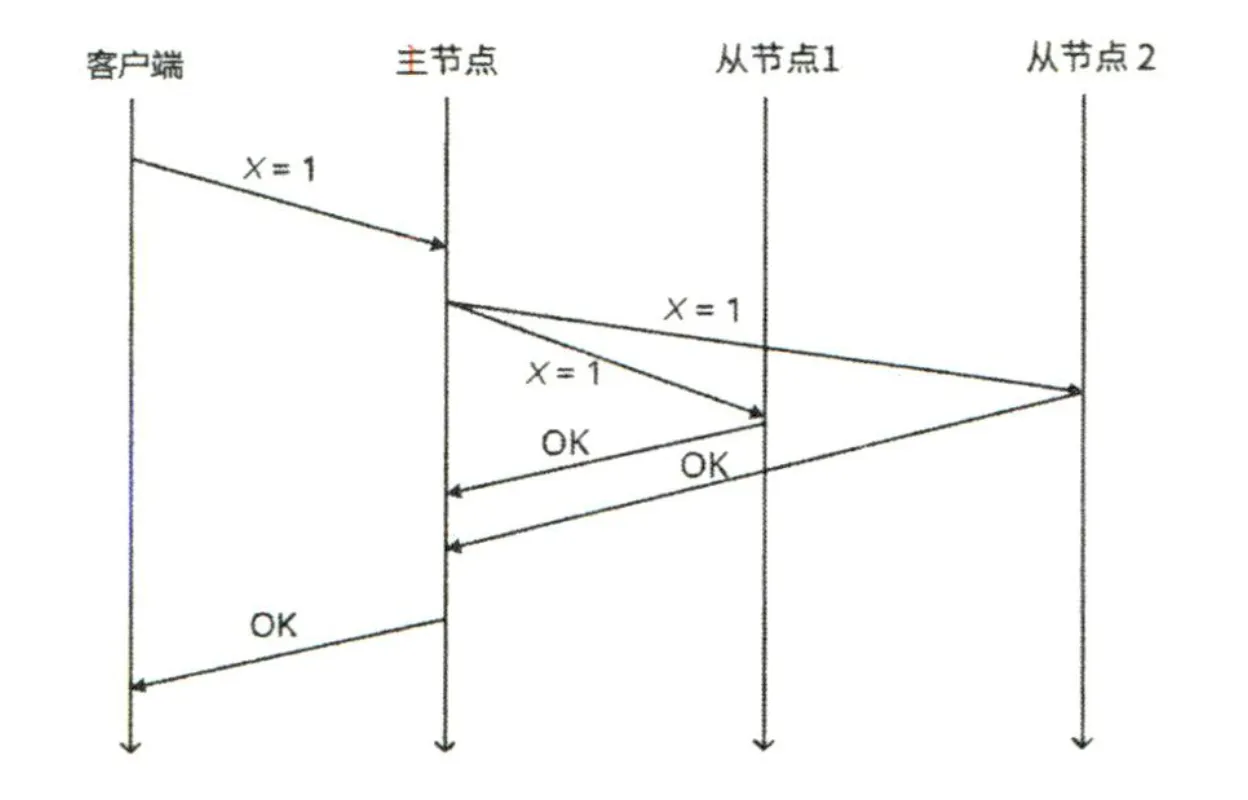
同步复制(Synchronous Replication)
如下图所示。同步复制中的主节点执行完一个写请求(或一个事务)后,必须等待所有的从节点都执行完毕,并收到确认信息后,才可以回复客户端写入成功。
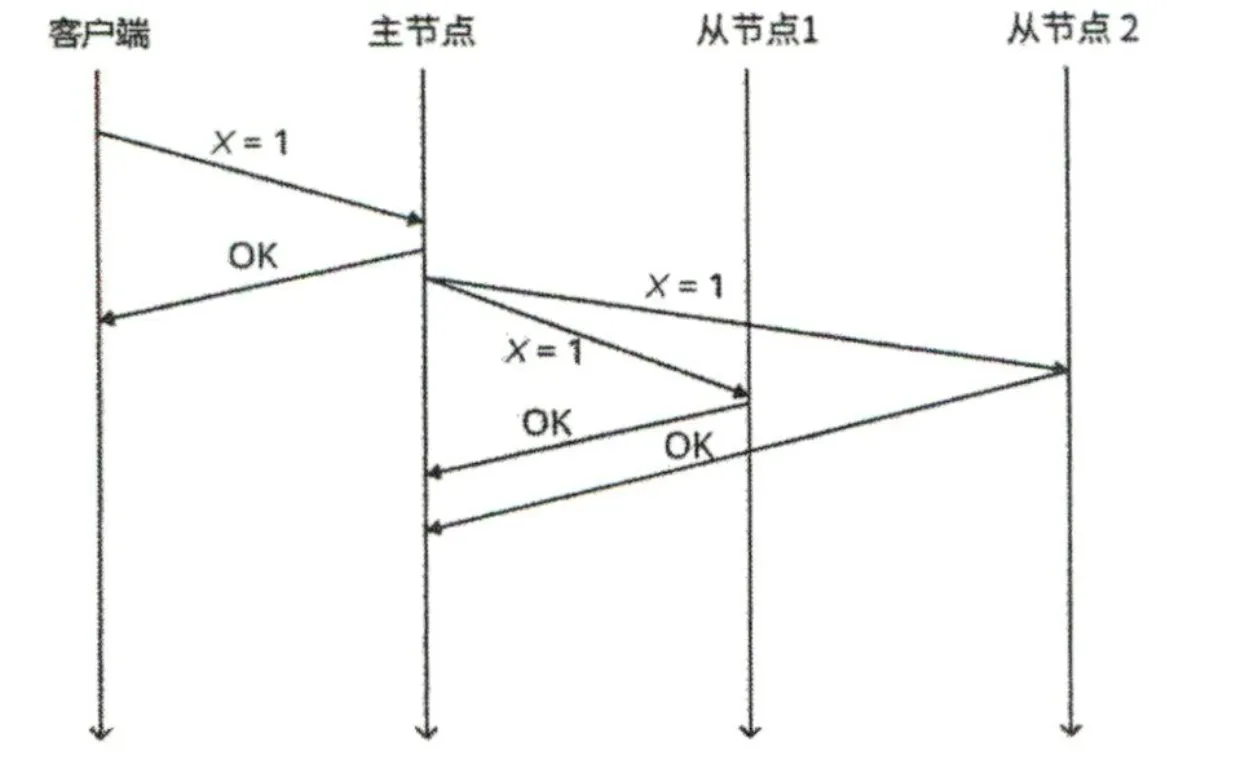
异步复制(Asynchronous Replication)
主节点执行完写请求后,会立即将结果返回给客户端,无须等待其他副本是否写入完成。如下图所示。
半同步复制(Semisynchronous Replication)
是介于同步复制和异步复制之间的一种复制机制,如下图。主节点只需要等待至少一个从节点同步写操作并返回完成信息即可,不需要等待所有的节点都完成。
单主复制的缺点:
- 面对大量写请求工作负载时系统很难进行扩展因为系统只有一个主节点,写请求的性能瓶颈由单个节点(主节点)决定。
- 当主节点岩机时,从节点提升为主节点不是即时的,可能会造成一些停机时间,甚至产生错误。
对于第2个缺点需要展开分析。一般来说,分布式系统执行故障切换有两种方法:手动切换和自动切换。对于手动切换的情况,一般由运维人员根据数据完整性来选择新的主节点,这是最安全的方法,但由于需要人工介入,可能导致较长的停机时间。
另一种方法是自动切换,即从节点通过心跳超时检测到主节点已经岩机,然后尝试成为整个集群的主节点。这种方式更快,不需要人工介入,能够自动容错,但也相对危险。倘若两个从节点同时检测到主节点失效,或者网络分区导致从节点认为主节点失效,但其实主节点仍然正常工作,这两种情况都会导致集群产生两个主节点。这种情况称为“脑裂(Split Brain)”两个主节点都在处理写请求,可能造成数据损坏之类的灾难性后果。
处理从节点的故障恢复就简单许多,如果从节点由于网络分区长时间无法与主节点同步,导致数据滞后,则可以通过日志偏移量与主节点继续同步数据。如果从节点故障不可恢复,则可以换上新的从节点重新复制主节点的数据。
4.复制算法-多主复制
多主复制和单主复制的显著区别是, 由于多主复制不止一个节点处理写请求,且网络存在延迟,这就意味着节点可能会对某些请求的正确顺序产生分歧,导致多个节点上的数据不一致,这种现象简称为数据冲突。例如下图的情况,由于写操作x≡1同步延迟,导致最后主节点1和从节点上的x的值为3,而主节点2上的X的值为1。这当然会引起很大的麻烦,因此系统必须要解决数据冲突。