一、简单动态字符串
1. 使用场景
Redis中所有的key都是使用了字符串对象,还有部分字符串类型的value
2. 数据结构
struct sdshdr{
				//记录buf数组中已使用字节的数量
				//等于SDS所保存字符串的长度
				int len;
				//记录buf数据中未使用字节的数量
				int free;
				//字节数据,用于保存字符串
				char buf[];
}SDS遵循C字符串以空字符结尾的惯例,保存空字符的1字节空间不计算在SDS的len属性里面,并且为空字符分配额外的1字节空间,以及添加空字符到字符串末尾等操作,都是由SDS函数自动完成的,所以这个空字符对于SDS的使用者来说是完全透明的。遵循空字符结尾这一惯例的好处是,SDS可以直接重用一部分C字符串函数库里面的函数,比方说可以直接使用<stdio.h>/printf函数
3. 与C字符串(char[])的区别
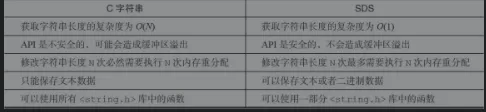
1)获取字符串长度的时间复杂度是O(1)
2 ) 杜绝缓冲区溢出
例如:SDS提供了sdscat函数,在执行拼接操作之前,会检查sds的空间是否足够,如果不够会先扩展
3)减少修改字符串时带来的内存重分配次数
内存重分配涉及复杂的算法,并且可能需要执行系统调用,所以比较耗时。Redis的Sds解决方案是空间预分配和惰性空间释放
a)空间预分配:sds在分配时不仅会分配所必须要的空间,还会为sds分配额外的未使用的空间,其中未使用的空间的数量由以下公式决定:
if len(扩展后) < 1MB
free = len ;//比如说len将变成13字节,那么len实际长度 是 13 + 13 + 1 byte
if len (扩展后 ) ≥ 1MB
free = 1MB //比方说len将变成30Mb,那么len实际长度是 30MB+1M+1 byte
b)惰性空间释放:在对sds进行一些操作后使得sds实际使用长度减小后,它并不会立即释放出多的空间,二是讲这些空间作为未使用空间保留在sds里面。当然,sds提供了主动回收这些空间的api
4)二进制安全
C字符串中的字符必须符合某周编码(比如ASCII),并且除了字符串的末尾之外,字符串里面不能包含空字符串,否则最先被读入的空字符串会被误认为是字符串结尾,这些使得C字符串只能保存文本,而不能保存图片、音频、视频等二进制数据。但是SDS是使用len属性的值而不是空字符串来判读字符串是否结束。
5)兼容部分C字符串函数
虽然SDS的API都是二进制安全的,但它们一样遵循C字符串以空字符结尾的惯例:这些API总会将SDS保存的数据的末尾设置为空字符,并且总会在为buf数组分配空间时多分配一个字节来容纳这个空字符,这是为了让那些保存文本数据的SDS可以重用一部分<string.h>库定义的函数
比如:SDS可以重用<string.h>/strcasecmp函数,使用它来对比SDS保存的字符串和另一个C字符串
strcasecmp(sds->buf,"hello world");//比对两个字符串
strcat(c_string,sds->buf);//拼接字符串6)小结
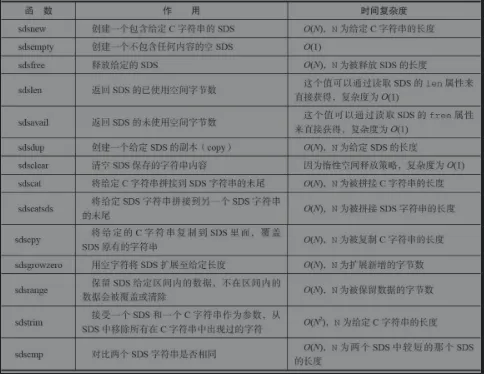
4. SDS的API
5. 重点回顾
- Redis只会使用C字符串作为字面量,在大多数情况下,Redis使用SDS(Simple Dynamic String,简单动态字符串)作为字符串表示。
比起C字符串,SDS具有以下优点:
- 常数复杂度获取字符串长度。
- 杜绝缓冲区溢出。
- 减少修改字符串长度时所需的内存重分配次数。
- 二进制安全
- 兼容部分C字符串函数。
二、链表
1. 使用场景
- 列表键的底层实现之一就是链表。当一个列表键包含了数量比较多的元素,又或者列表中包含的元素都是比较长的字符串时,Redis就会使用链表作为列表键的底层实现
- 发布与订阅、慢查询、监视器等功能也用到了链表,Redis服务器本身还使用链表来保存多个客户端的状态信息,以及使用链表来构建客户端输出缓冲区(output buffer)
2. 数据结构
/**
*每个链表节点使用一个adlist.h/listNode结构来表示
**/
typedef struct listNode{
	//前置节点
	struct listNode * prev;
	//后置节点
	struct listNode * next;
	//节点的值
	void * value;
} listNode;

/**
*虽然仅仅使用多个listNode结构就可以组成链表,但使用adlist.h/list来持有链表的话,操作起来会更方便
**/
typedef struct list{
	//表头节点
	listNode * head;
	//表尾节点
	listNode * tail;
	//链表所包含的节点数量
	unsigned long len;
	//节点值复制函数
	void * (*dup) (void *ptr)
	//节点值释放函数
	void * (*free) (void *ptr)
	//节点值对比函数
	void * (*match) (void *ptr,void *key)
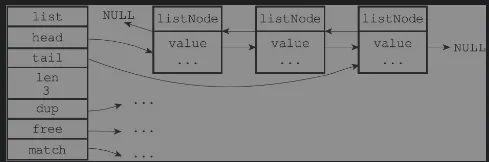
} list;- 由list结构和listNode结构组成的链表
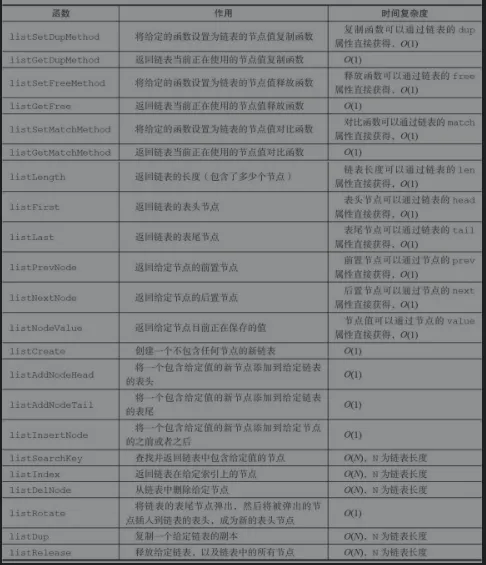
3. 链表和链表节点的API
4. 重点回顾
- 链表被广泛用于实现Redis的各种功能,比如列表键、发布与订阅、慢查询、监视器等。
- 每个链表节点由一个listNode结构来表示,每个节点都有一个指向前置节点和后置节点的指针,所以Redis的链表实现是双端链表。
- 每个链表使用一个list结构来表示,这个结构带有表头节点指针、表尾节点指针,以及链表长度等信息。
- 因为链表表头节点的前置节点和表尾节点的后置节点都指向NULL,所以Redis的链表实现是无环链表。
- 通过为链表设置不同的类型特定函数,Redis的链表可以用于保存各种不同类型的值。
三、字典
1. 使用场景
- 字典,又称为符号表(symbol table)、关联数组(associative array)或映射(map),是一种用于保存键值对(key-value pair)的抽象数据结构。
- Redis的数据库就是使用字典来作为底层实现的,对数据库的增、删、查、改操作也是构建在对字典的操作之上的
2. 数据结构
/**
*Redis字典所使用的哈希表由dict.h/dictht结构定义
**/
typedef struct dictht{
	//哈希表数组
	dictEntry **table;
	//哈希表大小
	unsigned long size;
	//哈希表大小掩码,用于计算索引值
	//总是等于size-1
  unsigned long sizemask;
	//该哈希表已有节点的数量
	unsigned long used;
}

//其中的哈希表节点
typedef struct dictEntry{
	//键
	void *key;
	//值
	union{//可以是一个指针,或者是一个uint64_t整数,又或者是一个int64_t整数。
		void *val;
		uint64_tu64;
		int64_ts64;
	}v;
	//指向下个哈希表节点,形成链表
	struct dictEntry *next;
} dictEntry;

/**
*Redis中的字典由dict.h/dict结构表示:
*/
typedef struct dict{
	//类型特定函数
	dictType * type;
	//私有数据
	void *privdata;
	//哈希表
	dictht ht[2];
	//rehash索引
	//当rehash不在进行时,值为-1
	int trehashidx;
} dict;

/**
*
*/
typedef struct dictType {
		uint64_t (*hashFunction)(const void *key);  //字典key哈希函数
    void *(*keyDup)(void *privdata, const void *key); //字典key复制函数
    void *(*valDup)(void *privdata, const void *obj);   //字典值复制函数
    int (*keyCompare)(void *privdata, const void *key1, const void *key2); //字典key比较函数
    void (*keyDestructor)(void *privdata, void *key); //字典key析构函数
    void (*valDestructor)(void *privdata, void *obj); //字典值析构函数
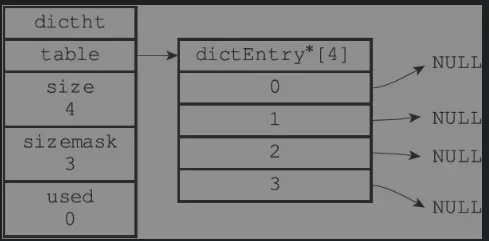
} dictType;- 一个空的哈希表
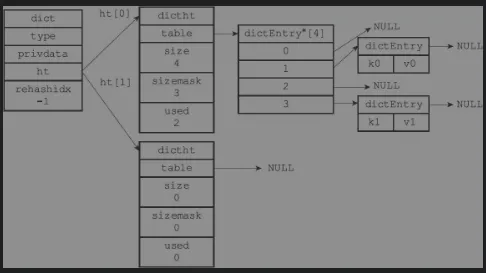
- 普通状态下的字典
3. 哈希算法
- Redis使用MurmurHash2算法来计算键的哈希值。MurmurHash算法最初由Austin Appleby于2008年发明,这种算法的优点在于,即使输入的键是有规律的,算法仍能给出一个很好的随机分布性,并且算法的计算速度也非常快。MurmurHash算法目前的最新版本为MurmurHash3,而Redis使用的是MurmurHash2,关于MurmurHash算法的更多信息可以参考该算法的主页:http://code.google.com/p/smhasher/
Redis计算哈希值和索引值的方法如下:
//使用字段设置的哈希函数,计算键key的哈希值 hash = dict ->type->hashFcuntion(key); //使用哈希表的sizemask属性和哈希值,计算出索引值 //根据情况不同,ht[x]可以是ht[0]也可以是ht[1] index = hash & dict->ht[x].sizemask;- 解决键冲突 - 链地址法(separate chaining)
4. rehash
(1)概念介绍
rehash是以bucket(桶)为基本单位进行渐进式的数据迁移的,每步完成一个bucket的迁移,直至所有数据迁移完毕。一个bucket对应哈希表数组中的一条entry链表。新版本的dictRehash()还加入了一个最大访问空桶数(empty_visits)的限制来进一步减小可能引起阻塞的时间。
- dictht->table:哈希表内部的table结构使用了链地址法来解决哈希冲突,刚开始看的时候我很奇怪,这怎么是个二维数组?这其实是一个指向数组的指针,数组中的每一项都是entry链表的头结点。
- dict->ht[2]:在dict的内部,维护了两张哈希表,平时只使用ht[0],只有在rehash的进行的中的时候才会使用ht[1],rehash完成之后ht[1]赋值给ht[0],将ht[1]进行reset。
- dict->rehashidx:因为是渐进式的哈希,数据从ht[0]迁移到ht[1]是逐步完成的,所以存储的是当前的rehash进度。当rehashidx为-1时,代表未进行rehash。
- reids可以再配置文件中配置是否开启rehash,配置项目为
activerehashing yes,默认为开启,此配置项针对数据库的dict与expires,如果开启了rehash配置,redis服务器会有一个定时器,每毫秒执行一次渐进式rehash,代码实现如下:
/* This function handles 'background' operations we are required to do
 * incrementally in Redis databases, such as active key expiring, resizing,
 * rehashing. */
void databasesCron(void) {
    /* Expire keys by random sampling. Not required for slaves
     * as master will synthesize DELs for us. */
    if (server.active_expire_enabled && server.masterhost == NULL) {
        activeExpireCycle(ACTIVE_EXPIRE_CYCLE_SLOW);
    } else if (server.masterhost != NULL) {
        expireSlaveKeys();
    }

    /* Defrag keys gradually. */
    if (server.active_defrag_enabled)
        activeDefragCycle();

    /* Perform hash tables rehashing if needed, but only if there are no
     * other processes saving the DB on disk. Otherwise rehashing is bad
     * as will cause a lot of copy-on-write of memory pages. */
    if (server.rdb_child_pid == -1 && server.aof_child_pid == -1) {
        /* We use global counters so if we stop the computation at a given
         * DB we'll be able to start from the successive in the next
         * cron loop iteration. */
        static unsigned int resize_db = 0;
        static unsigned int rehash_db = 0;
        int dbs_per_call = CRON_DBS_PER_CALL;
        int j;

        /* Don't test more DBs than we have. */
        if (dbs_per_call > server.dbnum) dbs_per_call = server.dbnum;

        /* Resize */
        for (j = 0; j < dbs_per_call; j++) {
            tryResizeHashTables(resize_db % server.dbnum);
            resize_db++;
        }

        /* Rehash */
        if (server.activerehashing) {
            for (j = 0; j < dbs_per_call; j++) {
                int work_done = incrementallyRehash(rehash_db);
                if (work_done) {
                    /* If the function did some work, stop here, we'll do
                     * more at the next cron loop. */
                    break;
                } else {
                    /* If this db didn't need rehash, we'll try the next one. */
                    rehash_db++;
                    rehash_db %= server.dbnum;
                }
            }
        }
    }
}
int incrementallyRehash(int dbid) {
    /* Keys dictionary */
    if (dictIsRehashing(server.db[dbid].dict)) {
        dictRehashMilliseconds(server.db[dbid].dict,1);
        return 1; /* already used our millisecond for this loop... */
    }
    /* Expires */
    if (dictIsRehashing(server.db[dbid].expires)) {
        dictRehashMilliseconds(server.db[dbid].expires,1);
        return 1; /* already used our millisecond for this loop... */
    }
    return 0;
}
int dictRehashMilliseconds(dict *d, int ms) {
    long long start = timeInMilliseconds();
    int rehashes = 0;

    while(dictRehash(d,100)) {
        rehashes += 100;
        if (timeInMilliseconds()-start > ms) break;
    }
    return rehashes;
}
函数调用为 serverCron -> databasesCron -> incrementallyRehash -> dictRehashMilliseconds,具体执行操作时间为1ms,在1ms的时间时间内每次rehash 100个数据桶。直到每个字典rehash完成。
(2) rehash函数的具体实现:
- 判断dict是否正在rehashing,只有是,才能继续往下进行,否则已经结束哈希过程,直接返回。
- 接着是分n步进行的渐进式哈希主体部分(n由函数参数传入),在while的条件里面加入对.used旧表中剩余元素数目的观察,增加安全性。
- 一个runtime的断言保证一下渐进式哈希的索引没有越界。
- 接下来一个小while是为了跳过空桶,同时更新剩余可以访问的空桶数,empty_visits这个变量的作用之前已经说过了。
- 现在我们来到了当前的bucket,在下一个while(de)中把其中的所有元素都迁移到ht[1]中,索引值是辅助了哈希表的大小掩码计算出来的,可以保证不会越界。同时更新了两张表的当前元素数目。
- 每一步rehash结束,都要增加索引值,并且把旧表中已经迁移完毕的bucket置为空指针。
- 最后判断一下旧表是否全部迁移完毕,若是,则回收空间,重置旧表,重置渐进式哈希的索引,否则用返回值告诉调用方,dict内仍然有数据未迁移。
(3)渐进式哈希的精髓在于:
- 数据的迁移不是一次性完成的,而是可以通过dictRehash()这个函数分步规划的,并且调用方可以及时知道是否需要继续进行渐进式哈希操作。
- 如果dict数据结构中存储了海量的数据,那么一次性迁移势必带来redis性能的下降,别忘了redis是单线程模型,在实时性要求高的场景下这可能是致命的。而渐进式哈希则将这种代价可控地分摊了,调用方可以在dict做插入,删除,更新的时候执行dictRehash(),最小化数据迁移的代价。
- 在迁移的过程中,数据是在新表还是旧表中并不是一个非常急迫的需求,迁移的过程并不会丢失数据,在旧表中找不到再到新表中寻找就是了
四、跳跃表
1. 使用场景
- 跳跃表(skiplist)是一种有序数据结构,它通过在每个节点中维持多个指向其他节点的指针,从而达到快速访问节点的目的。
- 跳跃表支持平均O(logN)、最坏O(N)复杂度的节点查找,还可以通过顺序性操作来批量处理节点。
- 在大部分情况下,跳跃表的效率可以和平衡树相媲美,并且因为跳跃表的实现比平衡树要来得更为简单,所以有不少程序都使用跳跃表来代替平衡树。Redis使用跳跃表作为有序集合键的底层实现之一,如果一个有序集合包含的元素数量比较多,又或者有序集合中元素的成员(member)是比较长的字符串时,Redis就会使用跳跃表来作为有序集合键的底层实现
- Redis使用跳跃表作为有序集合键的底层实现之一,如果一个有序集合包含的元素数量比较多,又或者有序集合中元素的成员(member)是比较长的字符串时,Redis就会使用跳跃表来作为有序集合键的底层实现。
2. 数据结构
typedef struct zskiplistNode{
	//层
	struct zskiplistLevel{
		//前进指针
		struct zskiplistNode *forward;
		//跨度
		unsigned int span;
	} level[];
	//后退指针
	struct zskiplistNode *backward;
	//分值
	double score;
	//成员对象
	rsobj *obj;

}zskiplistNode;

typedef struct zskiplist{
		//表头节点和表尾节点
		struct zskiplistNode *header *tail;
		//表中节点的数量
		unsigned long length;
		//表中层数最大的节点的层数
		int level;
}zskiplist;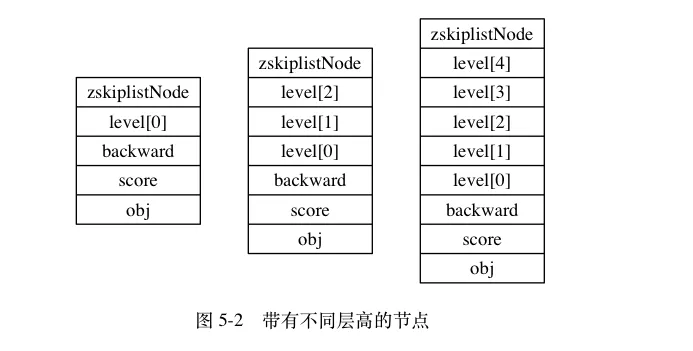
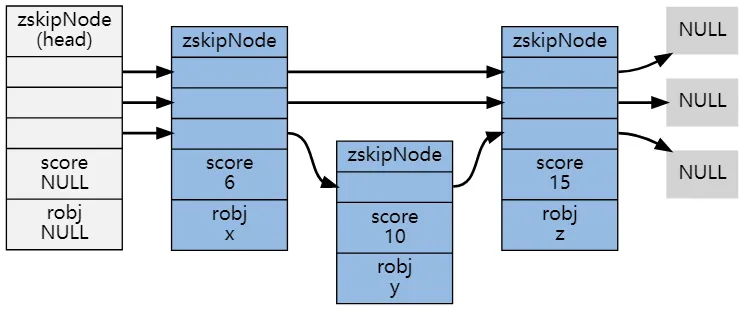
3.跳跃表数据结构每个字段的含义
zskiplist :
❑header:指向跳跃表的表头节点。❑tail:指向跳跃表的表尾节点。❑level:记录目前跳跃表内,层数最大的那个节点的层数(表头节点的层数不计算在内)。❑length:记录跳跃表的长度,也即是,跳跃表目前包含节点的数量(表头节点不计算在内)。
zskiplistNode:
❑层(level):节点中用L1、L2、L3等字样标记节点的各个层,L1代表第一层,L2代表第二层,以此类推。每个层都带有两个属性:前进指针和跨度。前进指针用于访问位于表尾方向的其他节点,而跨度则记录了前进指针所指向节点和当前节点的距离。在上面的图片中,连线上带有数字的箭头就代表前进指针,而那个数字就是跨度。当程序从表头向表尾进行遍历时,访问会沿着层的前进指针进行。
❑后退(backward)指针:节点中用BW字样标记节点的后退指针,它指向位于当前节点的前一个节点。后退指针在程序从表尾向表头遍历时使用。❑分值(score):各个节点中的1.0、2.0和3.0是节点所保存的分值。在跳跃表中,节点按各自所保存的分值从小到大排列。❑成员对象(obj):各个节点中的o1、o2和o3是节点所保存的成员对象
❑分值(score):各个节点中的1.0、2.0和3.0是节点所保存的分值。在跳跃表中,节点按各自所保存的分值从小到大排列。
❑成员对象(obj):各个节点中的o1、o2和o3是节点所保存的成员对象。
4.跳跃表实现
https://zhuanlan.zhihu.com/p/56941754
五、整数集合
1. 数据结构
typedef struct intset{
		//编码方式
		uint32_t encoding;
		//集合包含的元素数量
		uint32_t length;
		//保存元素的数组
		int8_t contents[];
} intset;
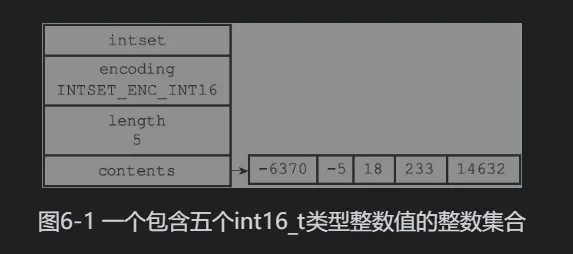
contents数组是整数集合的底层实现:整数集合的每个元素都是contents数组的一个数组项(item),各个项在数组中按值的大小从小到大有序地排列,并且数组中不包含任何重复项。length属性记录了整数集合包含的元素数量,也即是contents数组的长度。虽然intset结构将contents属性声明为int8_t类型的数组,但实际上contents数组并不保存任何int8_t类型的值,contents数组的真正类型取决于encoding属性的值:
❑如果encoding属性的值为INTSET_ENC_INT16,那么contents就是一个int16_t类型的数组,数组里的每个项都是一个int16_t类型的整数值(最小值为-32768,最大值为32767)。❑如果encoding属性的值为INTSET_ENC_INT32,那么contents就是一个int32_t类型的数组,数组里的每个项都是一个int32_t类型的整数值(最小值为-2147483648,最大值为2147483647)。
❑如果encoding属性的值为INTSET_ENC_INT64,那么contents就是一个int64_t类型的数组,数组里的每个项都是一个int64_t类型的整数值(最小值为-9223372036854775808,最大值为9223372036854775807)。
2. 特性总结
- 整数集合是集合键的底层实现之一。
- 整数集合的底层实现为数组,这个数组以有序、无重复的方式保存集合元素,在有需要时,程序会根据新添加元素的类型,改变这个数组的类型。
- 升级操作为整数集合带来了操作上的灵活性,并且尽可能地节约了内存。
- 整数集合只支持升级操作,不支持降级操作。
六、压缩列表
1. 使用场景
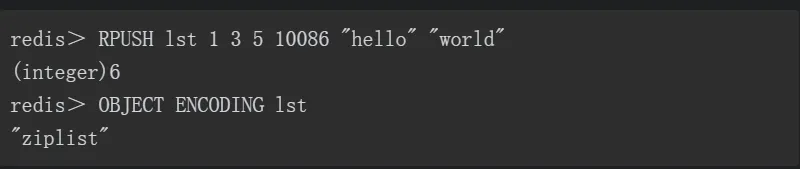
压缩列表(ziplist)是列表键和哈希键的底层实现之一。当一个列表键只包含少量列表项,并且每个列表项要么就是小整数值,要么就是长度比较短的字符串,那么Redis就会使用压缩列表来做列表键的底层实现。
2. 数据结构
typedef struct zlentry {
    unsigned int prevrawlensize;
    unsigned int prevrawlen;

    unsigned int lensize;
    unsigned int len;

    unsigned int headersize;

    unsigned char encoding;

    unsigned char *p;
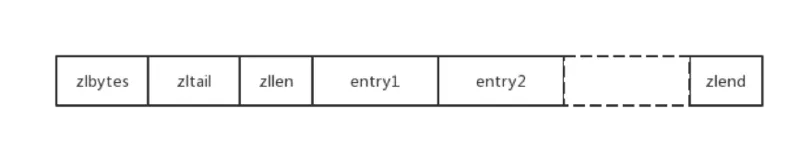
} zlentry;- 压缩列表(ziplist)
- 插入流程
3. 特性总结
- 压缩列表是一种为节约内存而开发的顺序型数据结构。
- 压缩列表被用作列表键和哈希键的底层实现之一。
- 压缩列表可以包含多个节点,每个节点可以保存一个字节数组或者整数值。
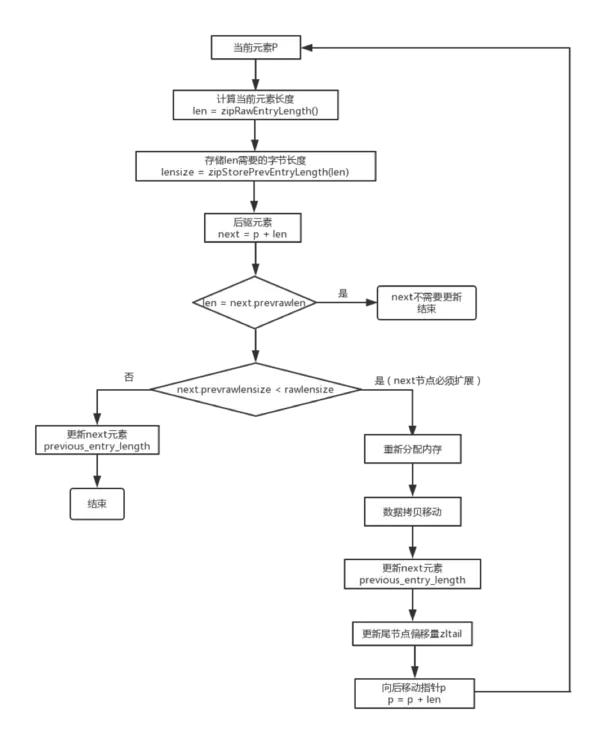
- 添加新节点到压缩列表,或者从压缩列表中删除节点,可能会引发连锁更新操作,但这种操作出现的几率并不高。
七、对象
1. 使用场景
Redis并没有直接使用这些数据结构来实现键值对数据库,而是基于这些数据结构创建了一个对象系统,这个系统包含字符串对象、列表对象、哈希对象、集合对象和有序集合对象这五种类型的对象,每种对象都用到了至少一种我们前面所介绍的数据结构。
2. 数据结构
/*
 * Redis 对象
 */
typedef struct redisObject {

    // 类型
    unsigned type:4;

    // 对齐位
    unsigned notused:2;

    // 编码方式
    unsigned encoding:4;

    // LRU 时间(相对于 server.lruclock)
    unsigned lru:22;

    // 引用计数
    int refcount;

    // 指向对象的值
    void *ptr;

} robj;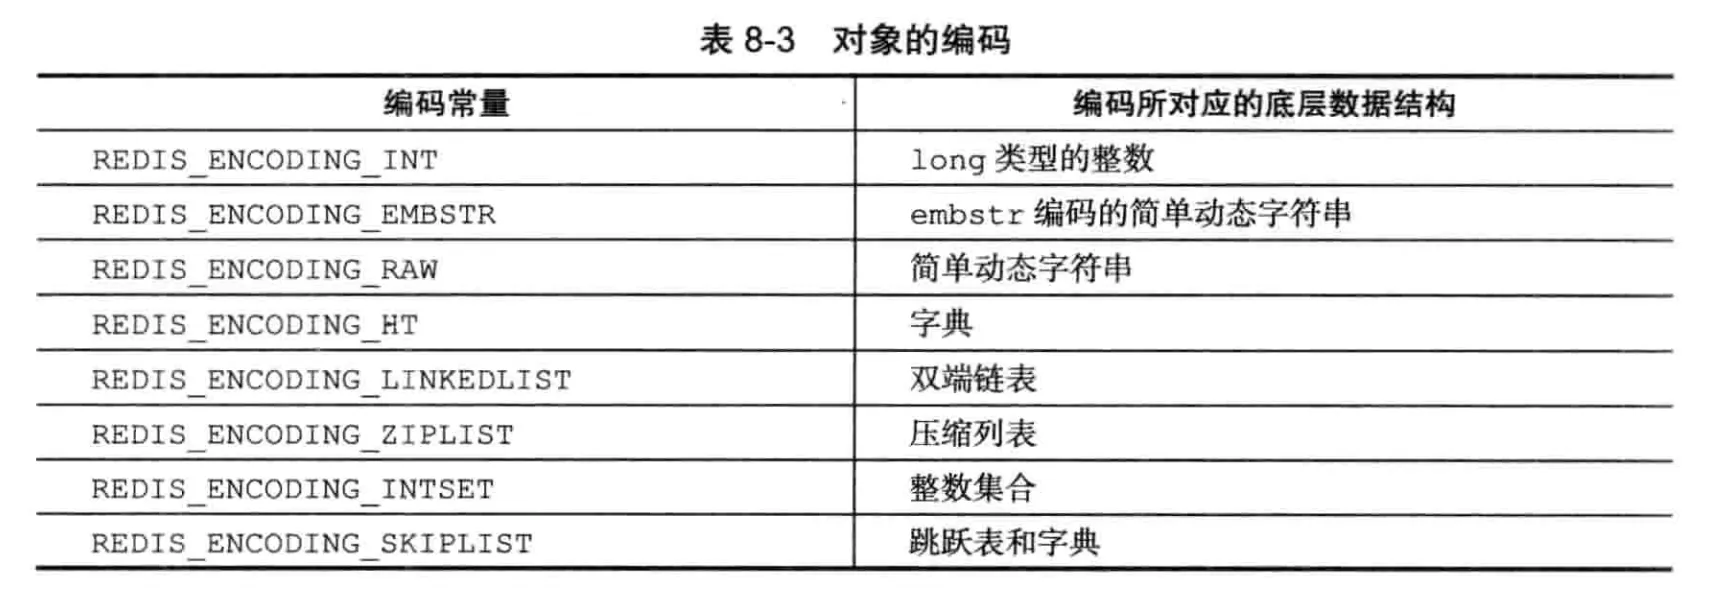
3. 常用对象
3.1 字符串对象
如果字符串保存的是一个字符串值,且长度<=39,则字符串对象使用的是embstr编码方式保存。
- embstr方式在内存分配时仅会调用一次内存分配函数,而raw会调用两次
- embstr字符串对象保存在一块连续的内存里面。
- 对embstr字符串执行任何修改命令时,程序会转换编码为raw
- 字符串对象是Redis五种类型的对象中唯一会被其他四种对象嵌套使用的
>SET msg "hello word"

>OBJECT ENCODING msg
"embstr"

>APPEND msg ' again!'
(integer) 18

>OBJECT ENCODING msg
"raw"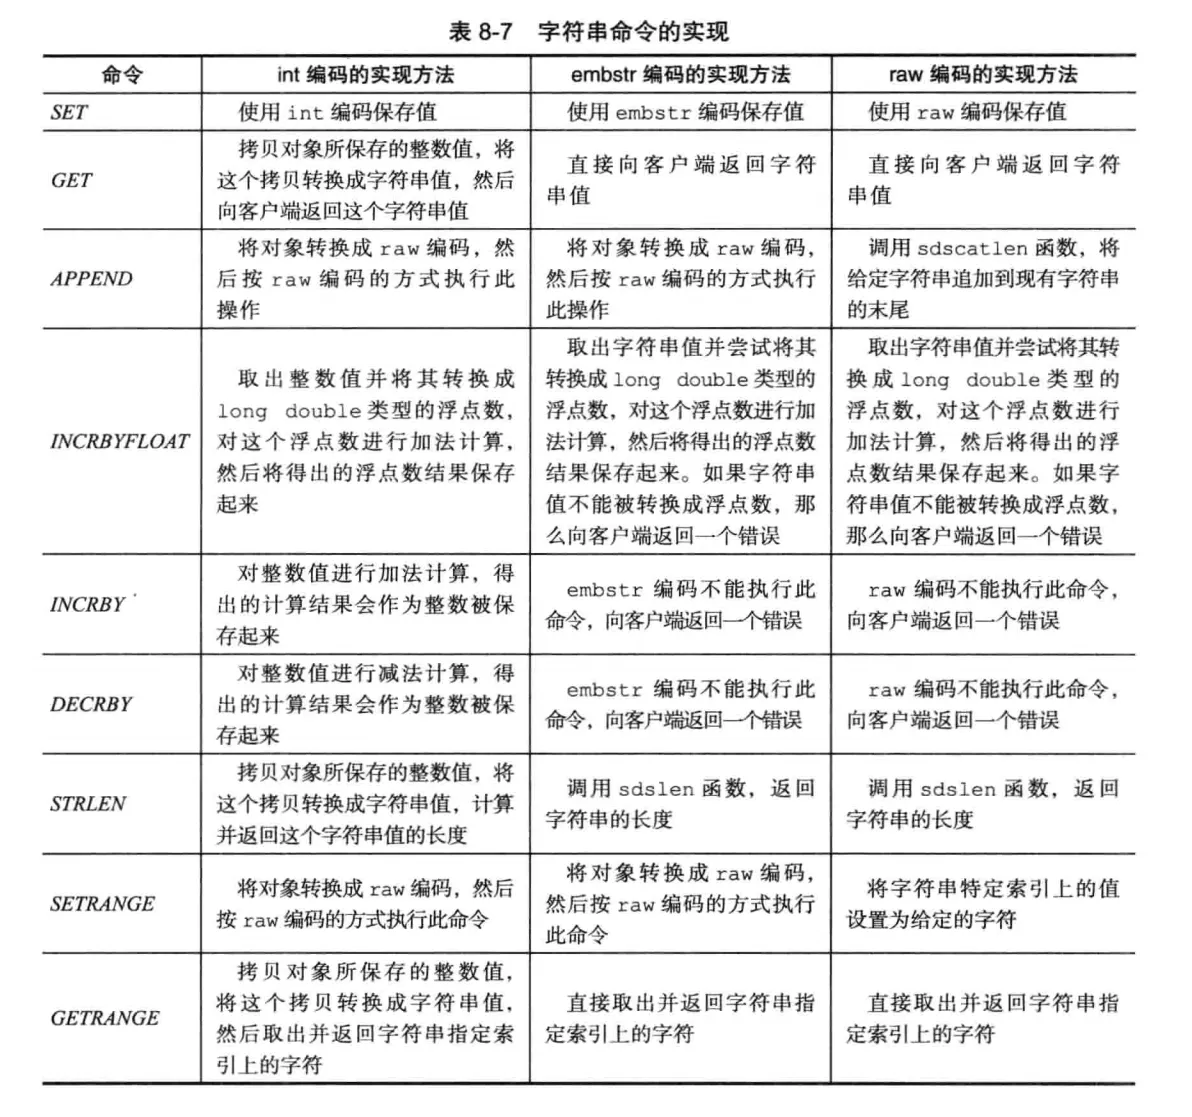
3.2
4. 特性总结
- Redis数据库中的每个键值对的键和值都是一个对象。
- Redis共有字符串、列表、哈希、集合、有序集合五种类型的对象,每种类型的对象至少都有两种或以上的编码方式,不同的编码可以在不同的使用场景上优化对象的使用效率。
- 服务器在执行某些命令之前,会先检查给定键的类型能否执行指定的命令,而检查一个键的类型就是检查键的值对象的类型。
- Redis的对象系统带有引用计数实现的内存回收机制,当一个对象不再被使用时,该对象所占用的内存就会被自动释放。
- Redis会共享值为0到9999的字符串对象。
- 对象会记录自己的最后一次被访问的时间,这个时间可以用于计算对象的空转时间。
Redis中的有序集合同时使用跳跃表和字段来实现
在理论上,有序集合可以单独使用字典或者跳跃表的其中一种数据结构来实现,但无论单独使用字典还是跳跃表,在性能上对比起同时使用字典和跳跃表都会有所降低。举个例子,如果我们只使用字典来实现有序集合,那么虽然以O(1)复杂度查找成员的分值这一特性会被保留,但是,因为字典以无序的方式来保存集合元素,所以每次在执行范围型操作——比如ZRANK、ZRANGE等命令时,程序都需要对字典保存的所有元素进行排序,完成这种排序需要至少O(NlogN)时间复杂度,以及额外的O(N)内存空间(因为要创建一个数组来保存排序后的元素)。