一、JMM与happen-before
1.1 为什么会存在“内存可见性”问题
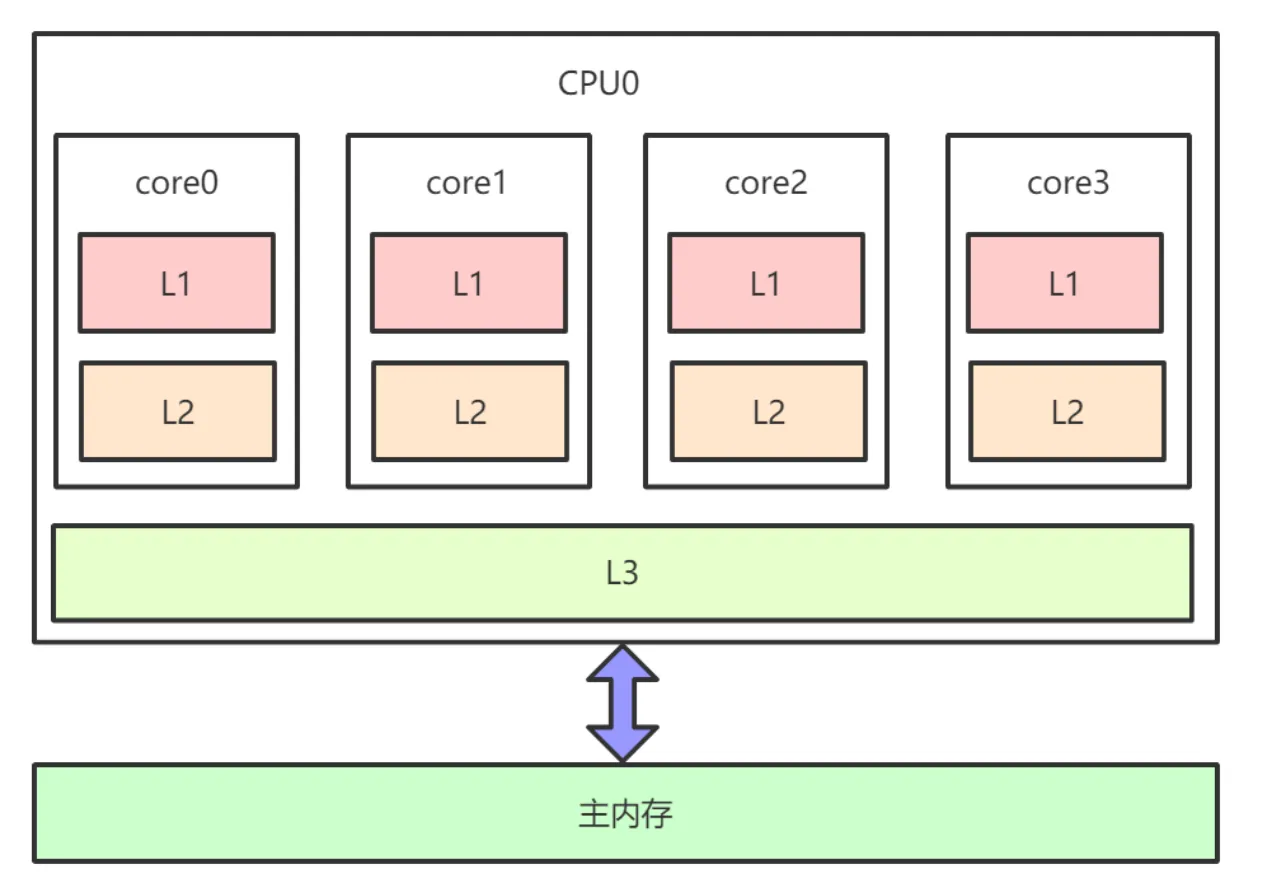
下图为x86架构下CPU缓存的布局,即在一个CPU 4核下,L1、L2、L3三级缓存与主内存的布局。
每个核上面有L1、L2缓存,L3缓存为所有核共用。
因为存在CPU缓存一致性协议,例如MESI,多个CPU核心之间缓存不会出现不同步的问题,不会有
“内存可见性”问题。
缓存一致性协议对性能有很大损耗,为了解决这个问题,又进行了各种优化。例如,在计算单元和
L1之间加了Store Buffer、Load Buffer(还有其他各种Buffer),如下图:
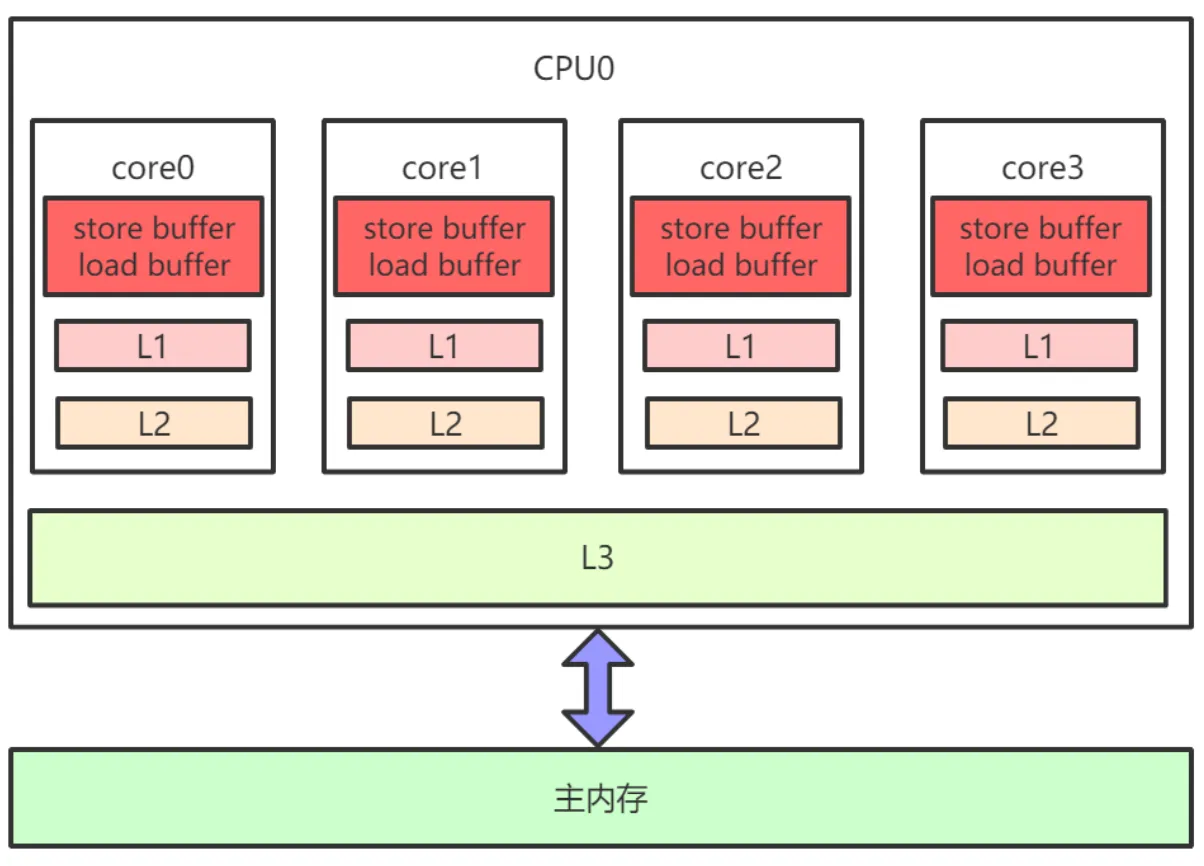
L1、L2、L3和主内存之间是同步的,有缓存一致性协议的保证,但是Store Buffer、Load Buffer和
L1之间却是异步的。向内存中写入一个变量,这个变量会保存在Store Buffer里面,稍后才异步地写入L1中,同时同步写入主内存中。
操作系统内核视角下的CPU缓存模型:
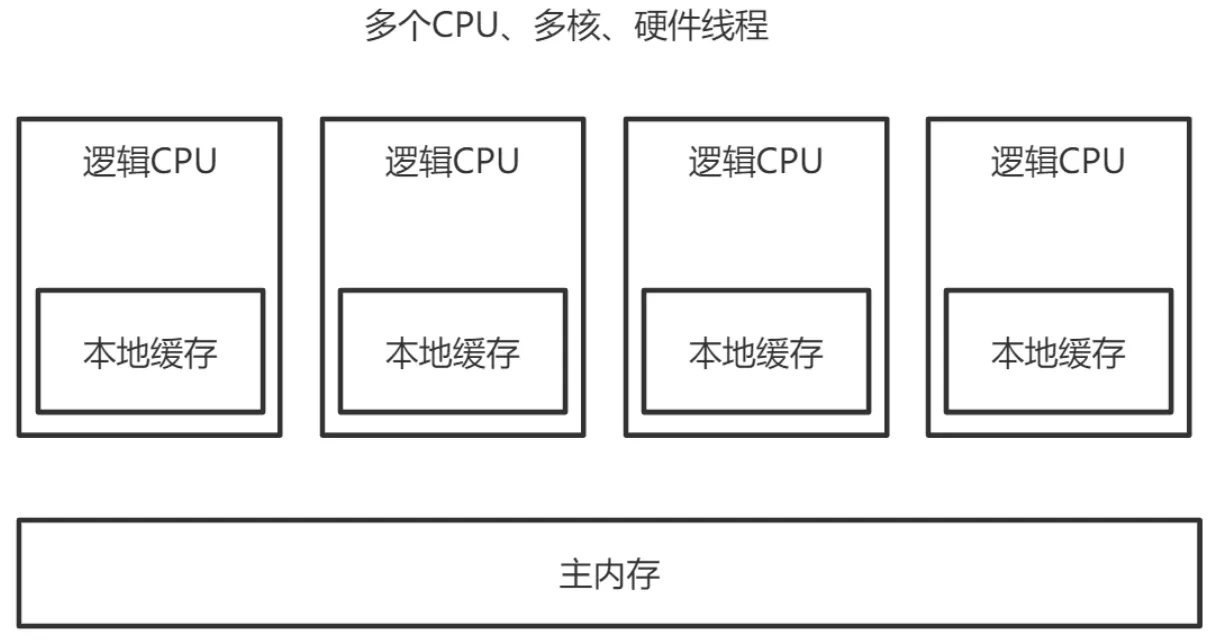
多CPU,每个CPU多核,每个核上面可能还有多个硬件线程,对于操作系统来讲,就相当于一个个
的逻辑CPU。每个逻辑CPU都有自己的缓存,这些缓存和主内存之间不是完全同步的。
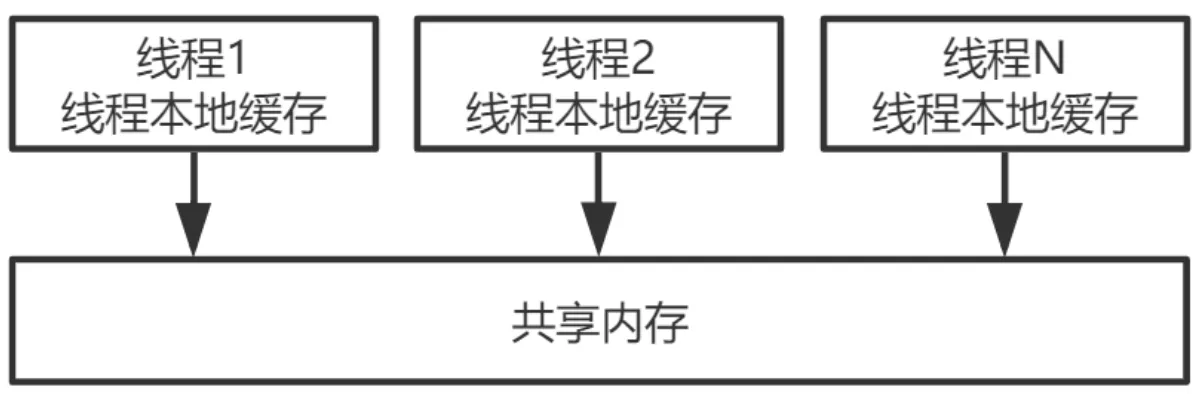
对应到Java里,就是JVM抽象内存模型,如下图所示:
1.2 重排序与内存可见性的关系
Store Buffer的延迟写入是重排序的一种,称为内存重排序(Memory Ordering)。除此之外,还
有编译器和CPU的指令重排序。
重排序类型:
- 编译器重排序。
对于没有先后依赖关系的语句,编译器可以重新调整语句的执行顺序。 - CPU指令重排序。
在指令级别,让没有依赖关系的多条指令并行。 - CPU内存重排序。
CPU有自己的缓存,指令的执行顺序和写入主内存的顺序不完全一致。
在三种重排序中,第三类就是造成“内存可见性”问题的主因,如下案例:
线程1:
X=1
a=Y
线程2:
Y=1
b=X
假设X、Y是两个全局变量,初始的时候,X=0,Y=0。请问,这两个线程执行完毕之后,a、b的正
确结果应该是什么?
很显然,线程1和线程2的执行先后顺序是不确定的,可能顺序执行,也可能交叉执行,最终正确的
结果可能是:
- a=0,b=1
- a=1,b=0
- a=1,b=1
也就是不管谁先谁后,执行结果应该是这三种场景中的一种。但实际可能是a=0,b=0。
两个线程的指令都没有重排序,执行顺序就是代码的顺序,但仍然可能出现a=0,b=0。原因是线程
1先执行X=1,后执行a=Y,但此时X=1还在自己的Store Buffer里面,没有及时写入主内存中。所以,线程2看到的X还是0。线程2的道理与此相同。
虽然线程1觉得自己是按代码顺序正常执行的,但在线程2看来,a=Y和X=1顺序却是颠倒的。指令没有重排序,是写入内存的操作被延迟了,也就是内存被重排序了,这就造成内存可见性问题。
1.3 内存屏障
为了禁止编译器重排序和 CPU 重排序,在编译器和 CPU 层面都有对应的指令,也就是内存屏障
(Memory Barrier)。这也正是JMM和happen-before规则的底层实现原理。
编译器的内存屏障,只是为了告诉编译器不要对指令进行重排序。当编译完成之后,这种内存屏障
就消失了,CPU并不会感知到编译器中内存屏障的存在。
而CPU的内存屏障是CPU提供的指令,可以由开发者显示调用。
内存屏障是很底层的概念,对于 Java 开发者来说,一般用 volatile 关键字就足够了。但从JDK 8开
始,Java在Unsafe类中提供了三个内存屏障函数,如下所示。
public final class Unsafe {
			// ...
			public native void loadFence();
			public native void storeFence();
			public native void fullFence();
			// ...
}
在理论层面,可以把基本的CPU内存屏障分成四种:
- LoadLoad:禁止读和读的重排序。
- StoreStore:禁止写和写的重排序。
- LoadStore:禁止读和写的重排序。
- StoreLoad:禁止写和读的重排序。
Unsafe中的方法: - loadFence=LoadLoad+LoadStore
- storeFence=StoreStore+LoadStore
- fullFence=loadFence+storeFence+StoreLoad
1.3 as-if-serial语义
重排序的原则是什么?什么场景下可以重排序,什么场景下不能重排序呢?
1.单线程程序的重排序规则
无论什么语言,站在编译器和CPU的角度来说,不管怎么重排序,单线程程序的执行结果不能改
变,这就是单线程程序的重排序规则。
即只要操作之间没有数据依赖性,编译器和CPU都可以任意重排序,因为执行结果不会改变,代码
看起来就像是完全串行地一行行从头执行到尾,这也就是as-if-serial语义。
对于单线程程序来说,编译器和CPU可能做了重排序,但开发者感知不到,也不存在内存可见性问
题。
2.多线程程序的重排序规则
编译器和CPU的这一行为对于单线程程序没有影响,但对多线程程序却有影响。
对于多线程程序来说,线程之间的数据依赖性太复杂,编译器和CPU没有办法完全理解这种依赖性
并据此做出最合理的优化。
编译器和CPU只能保证每个线程的as-if-serial语义。
线程之间的数据依赖和相互影响,需要编译器和CPU的上层来确定。
上层要告知编译器和CPU在多线程场景下什么时候可以重排序,什么时候不能重排序。
1.4 happen-before是什么
使用happen-before描述两个操作之间的内存可见性。
java内存模型(JMM)是一套规范,在多线程中,一方面,要让编译器和CPU可以灵活地重排序;
另一方面,要对开发者做一些承诺,明确告知开发者不需要感知什么样的重排序,需要感知什么样的重排序。然后,根据需要决定这种重排序对程序是否有影响。如果有影响,就需要开发者显示地通过
volatile、synchronized等线程同步机制来禁止重排序。
关于happen-before:
如果A happen-before B,意味着A的执行结果必须对B可见,也就是保证跨线程的内存可见性。Ahappen before B不代表A一定在B之前执行。因为,对于多线程程序而言,两个操作的执行顺序是不确定的。happen-before只确保如果A在B之前执行,则A的执行结果必须对B可见。定义了内存可见性的约束,也就定义了一系列重排序的约束。
基于happen-before的这种描述方法,JMM对开发者做出了一系列承诺:
- 单线程中的每个操作,happen-before 对应该线程中任意后续操作(也就是 as-if-serial语义保证)。
- 对volatile变量的写入,happen-before对应后续对这个变量的读取。
- 对synchronized的解锁,happen-before对应后续对这个锁的加锁。
JMM对编译器和CPU 来说,volatile 变量不能重排序;非 volatile 变量可以任意重排序。